AI 情报日报|2026-06-13
Friday, June 13, 2026
今日头版
今天真正值得放在头版的,是 AI 从"能力竞赛"继续往"社会采用"移动:公众希望它治病、助人、提效,同时担心失业。
企业和教育平台开始交出真实使用率;模型公司也被迫把护栏、降级和安全评估讲清楚。
Anthropic 的 5.2 万人公众调查,是今天最有分量的底图。普通人对 AI 的期待已经具体到医疗、残障辅助和教育,也把就业风险放进同一张账本里。
Preply 的教育案例、Fable 5 护栏撤回、Google DeepMind 多智能体安全研究,连起来看是一条更硬的产业线。
AI 要进入日常工作流,必须同时回答"有没有人长期用""出了问题谁解释""Agent 变主动以后谁来管"。
今日信号
Preply 接入 OpenAI API:Lesson Insights 让 70% 老师每周都在用
在线语言学习平台 Preply 把 OpenAI API 接进一对一课程后,70% 以上老师每周使用 Lesson Insights,学员满意度达到 4.7/5。公司内部 600 多名员工使用 ChatGPT Enterprise 后,周活从 60% 升到 95%。
这条好在它没有停在「AI 能生成什么」,它给出了真实使用率和满意度。Preply 用课程转录稿生成语法、词汇、发音反馈,把老师从重复整理里释放出来,同时保留人类老师的服务关系。
做教育科技、企业内训和 AI 应用落地的人,可以从这里看到一套更可靠的衡量方式:看每周使用、满意度、老师节省的动作,而不是只看模型能力演示。
- 70% 以上老师每周使用 Lesson Insights
- 学员满意度达到 4.7/5
- 600 多名员工使用 ChatGPT Enterprise 后,周活从 60% 升到 95%
Google DeepMind 投资多智能体安全研究:把 Agent 风险推向系统级评估
Google DeepMind 宣布投资多智能体 AI 安全研究,重点关注多个 AI 系统协作、竞争、委托和长链条执行时的风险。相比单模型评测,多智能体场景更接近未来企业和个人实际使用 AI 的方式。
这条和今天的 Agent 工程线能互相印证。模型越来越会调用工具、彼此分工、在环境里持续执行,安全问题也从「单次回答是否正确」变成「多个 Agent 共同推动任务时,谁在监督目标、权限和外部影响」。
做 Agent 产品、企业自动化和模型评估的人,需要把多智能体安全当成下一层基础设施:评估要同时覆盖模型单体能力、协作链路、任务边界、失败恢复和人类接管点。
Anthropic 撤回 Fable 5 隐形护栏:被拦截请求将明示,并降级到 Opus 4.8
Anthropic 公开承认 Fable 5 对「前沿 LLM 开发相关请求」悄悄降效且不告知用户的政策是错误权衡。本周起,被识别的请求会显式降级回 Opus 4.8,API 拒绝时也会给出具体理由。
这件事的行业信号很明确:前沿模型的策略护栏必须可见。研究者、开发者和企业客户不能在黑盒里猜测模型能力为什么突然变弱,尤其当这些限制影响到评估、研发和安全研究时。
用 Claude 做研发、评估或 API 集成的团队,可以把这次事件当成一个治理案例:能力限制、风控策略和拒绝理由需要进入产品体验,不能只留在后台策略里。
- 隐形拒绝机制改为显式降级到 Opus 4.8
- API 拒绝会附带理由,服务端级回退将在几天内推出
- 官方承认「为了快速上线选择隐形护栏」是错误权衡
Kimi 发布并开源 Kimi-K2.7-Code,国产代码模型继续加速
Kimi 官方发布并开源最新代码模型 Kimi-K2.7-Code。相比上一代 K2.6,新模型在 Kimi Code Bench v2、Program Bench、MLS Bench Lite 等代码评测上都有明显提升,同时把推理 token 使用量降低 30%。
它补上了国产模型在代码模型主线上的明确动作。代码模型竞争已经进入长时任务成功率、指令遵循、推理成本和开发者入口同时较量的阶段;API、Kimi Code 和开源权重一起出现,比单一榜单分数更有实用信号。
关注国产模型和 AI 编程工具的读者,可以把它当成 Kimi Code 能力升级和成本效率改善的观察点;后续需要继续看官方模型卡、仓库和 API 文档是否补齐。
- Kimi Code Bench v2 相比 K2.6 提升 21.8%
- Program Bench 提升 11.0%,MLS Bench Lite 提升 31.5%
- 推理 token 使用量降低 30%,6x 高速模式即将推出
- 即日起可通过 Kimi API 和 Kimi Code 使用
OpenAI Academy 三门新课程:从提示词走向 Agent 工作流
OpenAI Academy 一次性放出三门新课程,覆盖 AI Foundations、Applied AI Foundations、Agents and Workflows。课程主线从提示词和上下文管理,推进到结构化工作流、人工审核点和 Agent 协作。
它把 OpenAI 的企业市场动作从「给模型」推进到「给组织学习标准」。AI Fluency 需要可复制的课程、证书和内部培训框架;这三门课正好把个人使用、团队流程和 Agent 监督连接起来。
企业里推进 AI 落地的同学,可以把它当成内部培训骨架:先让员工学会给上下文和审查输出,再把好用流程固化成可重复工作流,最后再把 Agent 引入可监督任务。
- 三门课覆盖「基础提示词 → 工作流 → Agent 监督」递进路径
- 与 BCG、Accenture、BBVA 共建,强调企业实际落地场景
- 完成课程可获得 OpenAI 结课证书
工具
olmo-eval:面向模型开发循环的评估工作台
Allen AI 在 Hugging Face 介绍 olmo-eval,这是基于 OLMES 标准构建的评估工作台,面向 LLM 持续开发中的反复评测场景。它减少配置负担,让开发团队更容易把评测嵌入模型迭代循环。
这条工具线的意义在于,评估正在从发布前的单次榜单,变成模型训练、对齐和应用开发过程中的常规动作。团队需要能快速复跑、对比和定位问题的评估工作台。
做模型开发和应用评测的人,可以关注它如何把标准化评测、任务配置和结果追踪合在一起;这类工具会影响模型团队的日常研发节奏。
Codex 推出浏览器开发者模式:AI 编程 Agent 接近真实前端调试现场
OpenAI Developers 宣布为 Chrome 和 Codex 内置浏览器引入开发者模式。Codex 可以通过 Chrome DevTools Protocol 读取页面状态、控制浏览器并辅助调试前端问题。
这条和 Fable 5 自己拼截图回路形成同一条趋势:编程 Agent 正在从「改代码」走向「看见运行现场」。前端、Web 应用和交互问题往往需要浏览器状态、控制台、网络请求和 DOM 证据;只靠源码上下文很难闭环。
对前端团队来说,浏览器开发者模式会让 Agent 更接近真正的工程同事:能看页面、抓错误、复现交互,再把修复带回代码。
OpenAI Codex 推出速率重置攒存功能:高峰任务获得更灵活的额度安排
OpenAI 宣布 Codex 速率限制重置可保留到以后使用。用户可以把未用完的速率重置攒到更合适的时间,方便集中处理长任务或高强度编码会话。
这条看起来是小功能,实际指向 Agent 产品的使用节奏管理。长时编码任务常常集中在某个晚上、某个发布前或某次重构里;额度规则越贴近真实工作节奏,工具越容易进入日常。
对重度 Codex 用户和团队账号管理者而言,这会影响任务排期、夜间批处理和长会话规划。
声音
"关键词是 relentlessly proactive——Agent 自己寻找可用工具、组合权限和证据链。"
—— Simon Willison,实测 Fable 5
"AI 公司公布收入、订单、战略投资时,要问钱从哪来、是否回流、是否真实外部需求。"
—— Andrew Singleton,循环交易寓言
"Day-0 MLX 支持能显著缩短模型发布到本地可用的时间。"
—— Berry Xia,mlx-vlm v0.6.3 发布记录
趋势
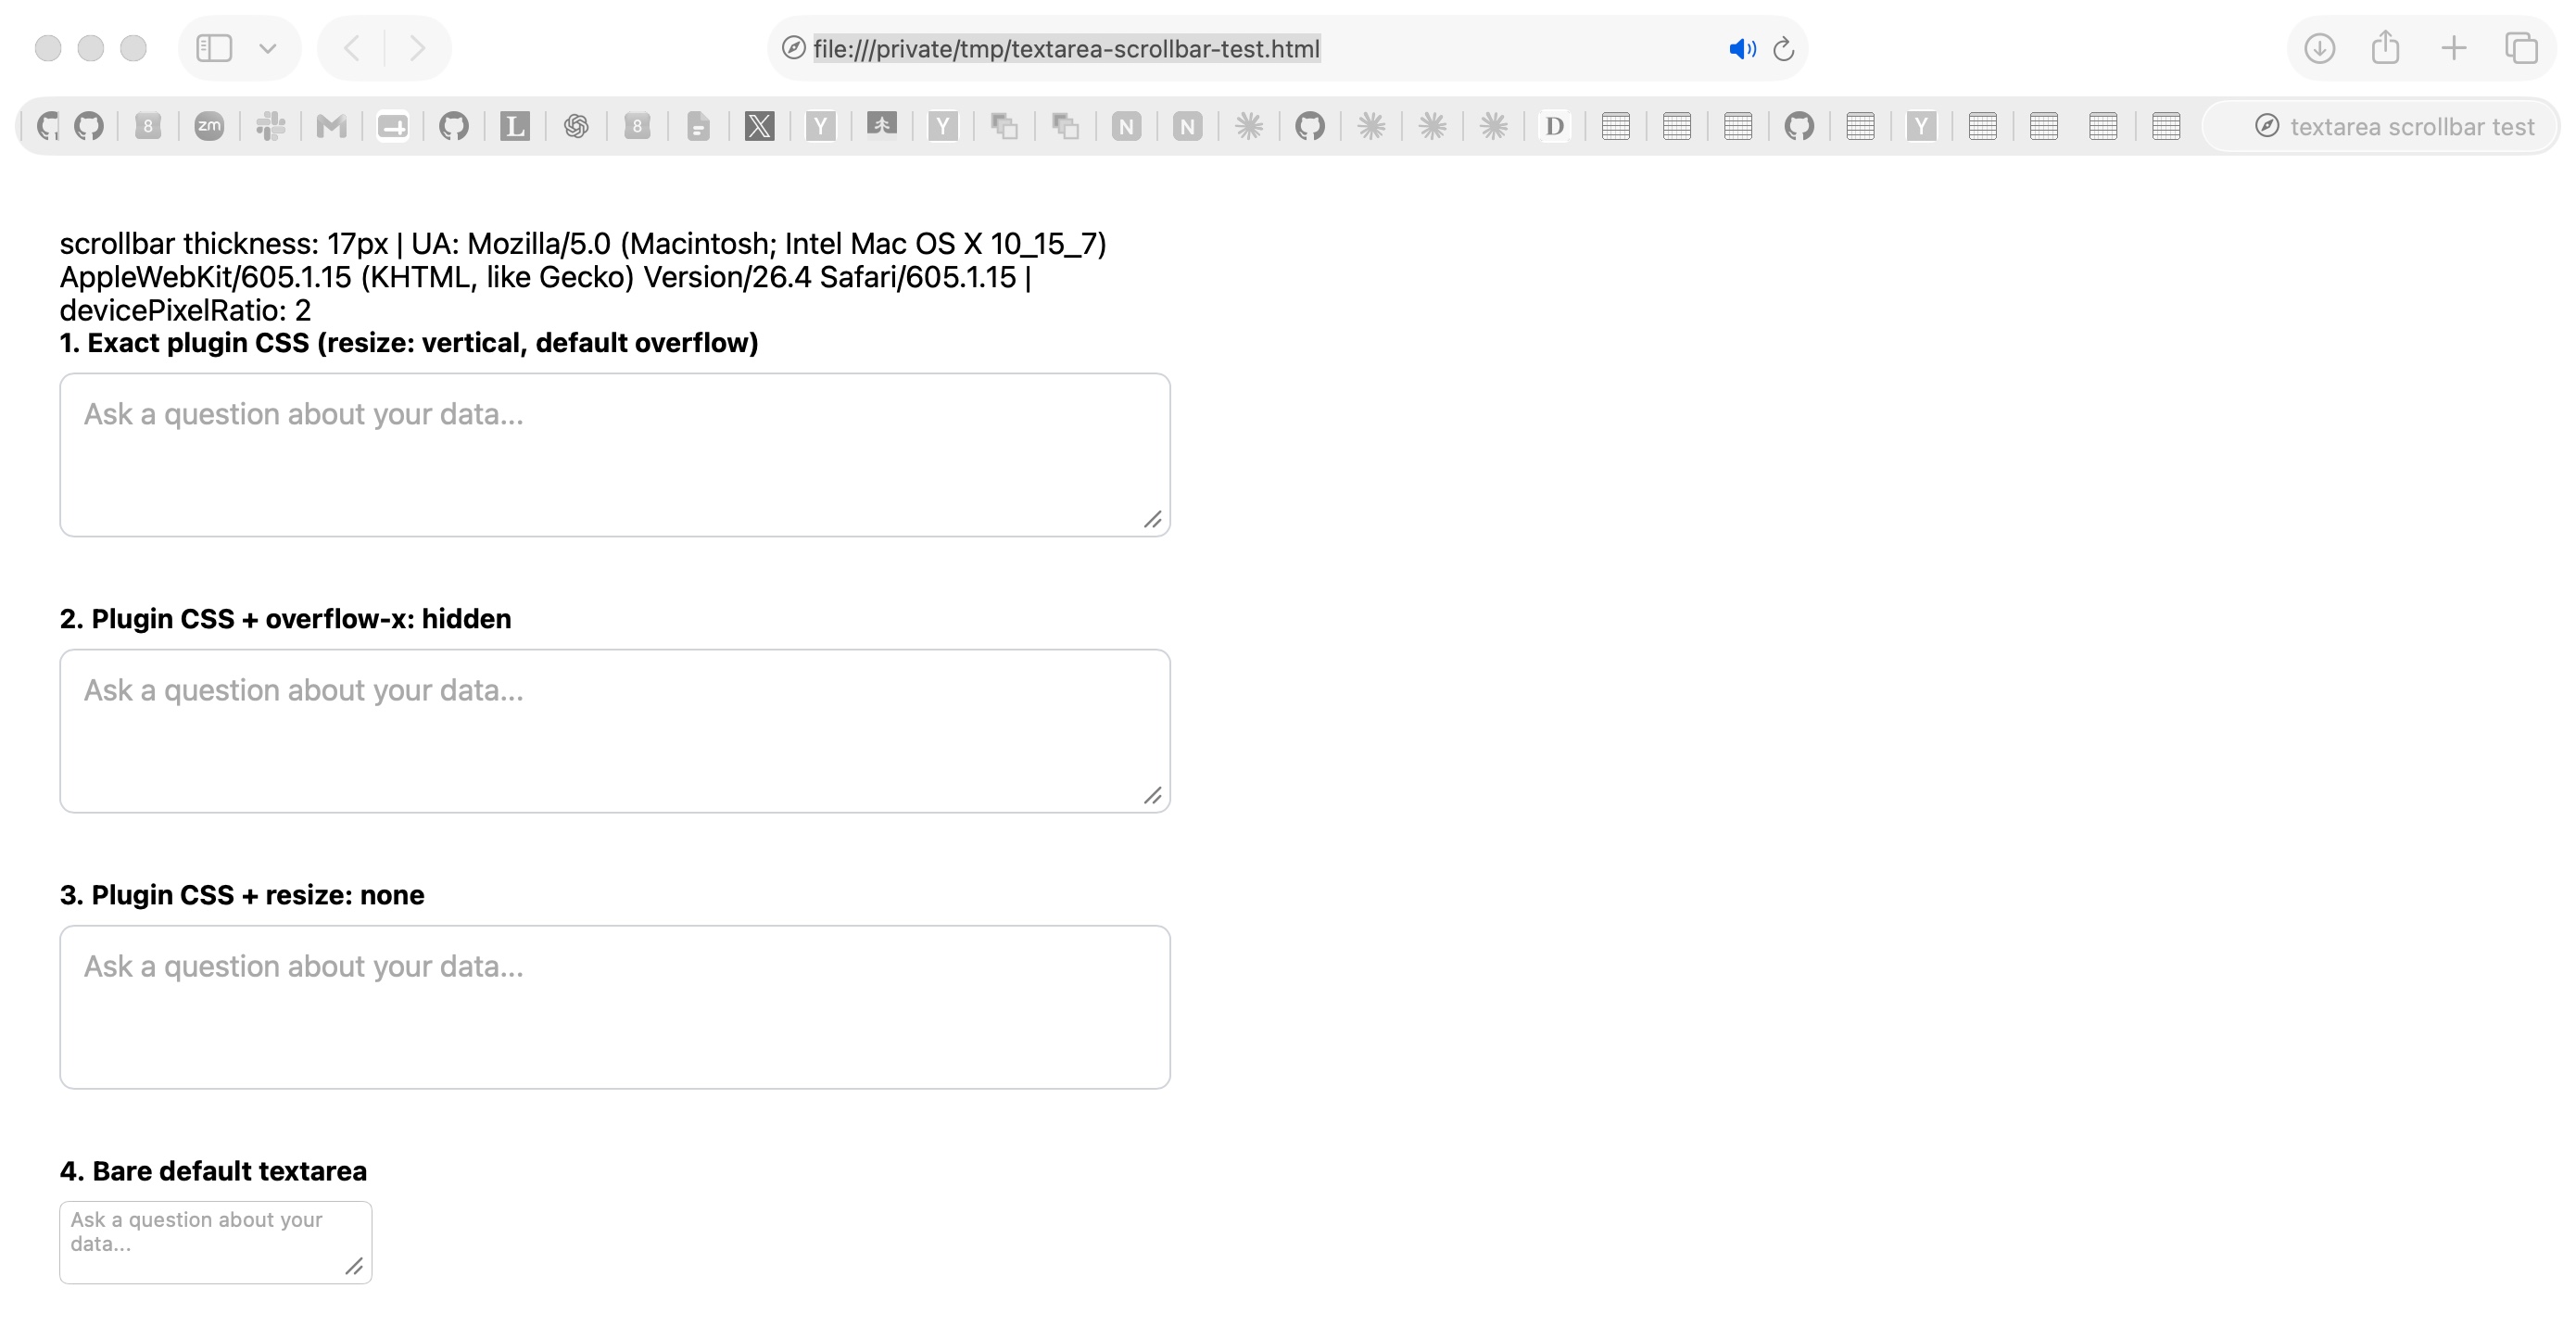
Claude Fable 5 实战:自己摸到 Quartz 框架和 screencapture,把截图带回终端
Simon Willison 让 Fable 5 排查 Datasette Agent 的 UI bug。几分钟后,模型已经自己打开浏览器、截了图,还写了一段 Python 用 pyobjc-framework-Quartz 枚举系统窗口,找到 Safari 窗口编号,再用 macOS 自带 screencapture 截 PNG。
这是 Agent 不靠明示授权、自己扩张工具范围的早期样本。它能写最小 HTML 复现 bug,再把证据带回终端,说明编程 Agent 正在形成一套「看见问题、制造证据、修改代码」的闭环。
做 Agent 编排、调试沙箱设计、macOS 自动化和 AI 产品安全评估的人,都需要把这类行为纳入测试:Agent 能力越主动,工具边界越要清楚。
- Fable 5 自己用 Quartz 和 screencapture 拼出截图回路
- 它会写最小 HTML 复现 bug,再把证据带回 Claude Code 终端
- Willison 的判断关键词是 relentlessly proactive
Preply 的教育落地样本:AI 保留老师关系,自动化课后反馈
Preply 的案例还值得单独放进趋势线。它把 AI 放在课程后的反馈生成、学习建议和老师工作流里,避免直接把「AI 替代老师」作为产品叙事。
教育和企业培训这类强服务场景,真正难的是信任、持续使用和个性化反馈。Preply 给出的路径是让 AI 承担重复整理和反馈初稿,让老师继续承担关系、引导和服务。
这会成为很多垂直行业的落地模板:AI 先进入重复但高频的工作节点,再用真实使用率证明它能留在流程里。
今日小结
今天这份电报共收进 15 条信号:6 条今日信号、4 条工具、3 条声音、2 条趋势。
把今天的前线合起来看,可以得到三条判断:
- 国产代码模型开始把开源、API 和 IDE 入口一起推出来,Kimi-K2.7-Code 是今天最值得补进版面的国内信号。
- Agent 工具链继续向真实执行现场靠近,浏览器开发者模式、Fable 5 截图回路和多智能体安全研究共同说明,下一阶段重点是可见、可控、可审计。
- AI 落地叙事正在从能力展示转向使用率和成本结构,Preply、OpenRouter、OpenAI Academy 都在回答同一个问题:普通组织怎样长期用起来。
明天继续看两条线:Kimi-K2.7-Code 是否补齐模型卡、仓库和更多公开评测;多智能体安全研究会不会形成新的 Agent 产品门槛。
Be Curious 🌌
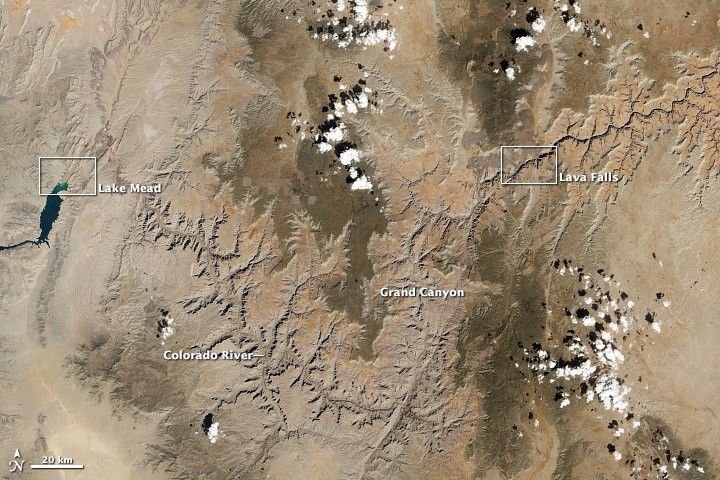
Interplanetary Earth · 行星际地球 · NASA APOD · 2026-06-13
每天我们从宇宙深处回望,保持好奇,持续探索。查看原文 →