AI 情报日报|2026-06-19
2026年6月19日 · 星期五
今日头版
半夜三点,Nvidia的GEAR实验室灯还亮着——但没有人在。几个AI编码Agent自己写代码、自己测试、自己调参数,教机器人往主板里插GPU和剪扎带。成功了99%。实验室负责人Jim Fan说:"我们早上来只看报告。"
而Midjourney——你去年输入"cat"它给你猫图的那个公司——现在造了一个全身超声波扫描仪。你站上去,一圈传感器从上到下扫过你全身,看你的肌肉、脂肪、骨骼怎么变化。CEO Holz说:"我也许想每天都看一遍我的身体数据。"
前线·大厂竞争·AI Agent·前线感
前线
半夜没人,AI Agent自己教机器人装GPU——成功了99%
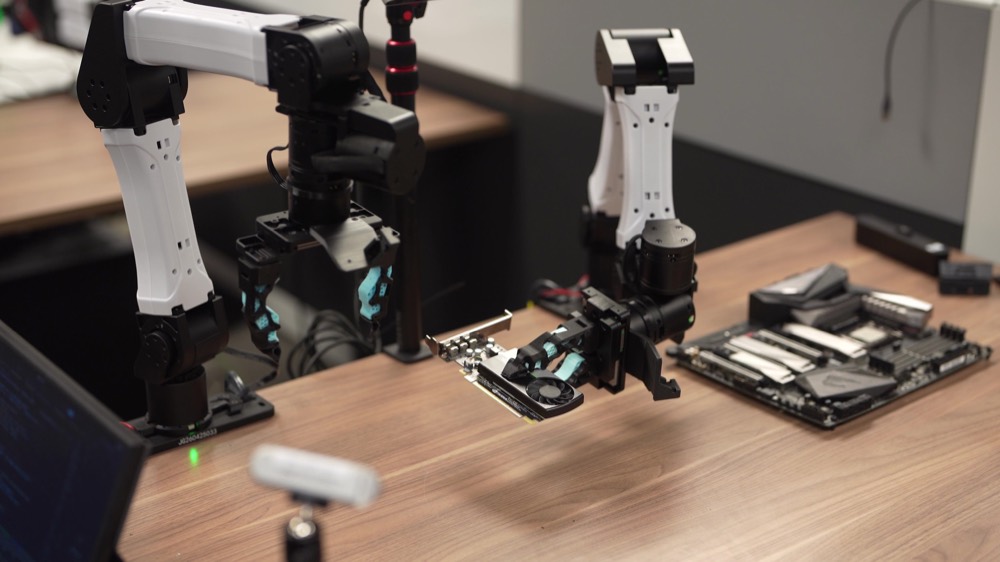
Nvidia的GEAR实验室做了一件事:给AI编码Agent一个机器人实验室、一些算力和一个"慷慨的token预算",然后人全部离开。Agent自己写训练代码、自己测试、自己看日志调参数、自己读论文改算法——教机器人往主板里插GPU、剪扎带、整理针盒。
插针任务的成功率近100%,比人类设计的in-the-loop方法还快。Jim Fan说:"GEAR实验室的一部分现在整夜自我改进——我们早上来只看报告。"他还开玩笑说:"我们都放假,Jensen都不会注意到。"
Ars Technica · Nvidia Research
前线·具身智能·AI Agent·这也行?
Midjourney 推出全身超声波 CT:35.8 万阵元、号称 50 年首个新模态——但还没有任何诊断验证
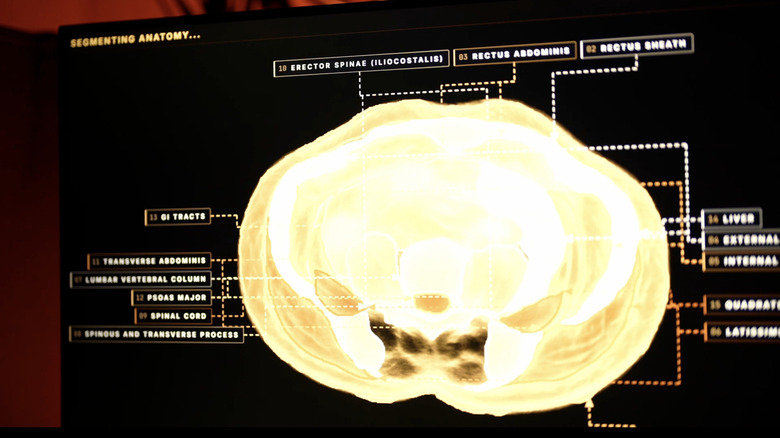
6 月 17 日 Midjourney 发布 Midjourney Scanner:环形水浸式全身超声波 CT。
结构上,8960 个传感器 × 40 套系统组成一圈,总共 358,000 个超声波阵元,直径 70 厘米,扫描时每秒产出约 17GB 数据,单块身体切片约 40GB,重建要用 21 台服务器。CEO David Holz 称这是"50 年来第一个新的全身医学成像模态"。
现状很诚实:团队约 9 人,至今只扫过约 12 个人,一次扫描要 20 分钟(卡在带宽、算法、DSP),分辨率宣称到 0.5mm。公司同时宣布在旧金山 Union Square 开 Midjourney Spa——约 25000 平方英尺、四层楼、9-10 台扫描仪,目标 2027 年底开业。已和 FDA 启动讨论。
远景数字很大:目标 5 万台扫描仪、每月 10 亿次扫描;Holz 说不到 12 台满速机器就能扫出全球 MRI 的总量,单次成本可能比 MRI 便宜几个数量级,但铺几千家 Spa 需要约 200 亿美元前期投入。质疑同样硬:没有临床验证、没有灵敏度/特异度数字。
这台机器能不能真看病还早,但它意味着 AI 实验室开始造"给 AI 喂身体数据的设备"——模型之后再抢数据管道。
前线·AI设计·产品转折·人的代价
GLM-5.2 通过"手感检验":知识工作基准排第三、成本只要 Fable 的 1/13——但这不是跑分刷出来的
AINews 把 6 月 19 日称为 GLM-5.2 的突破日。圈内对开源模型一向有"benchmaxxed"的警惕。这次是真实使用手感:Jeremy Howard(以不吹牛著称)说它"至少和 Opus 4.8、GPT-5.5 一样好",短板是没有视觉;Mat Velloso 说它是第一个通过他"日常主力"标准的开源模型。
Artificial Analysis 的新基准 AA-Briefcase 给出硬数据:它围绕跨数周的项目、上千份碎片化输入模拟真实知识工作。GLM-5.2 拿 1266 Elo,排 Fable 5(1587)和 Opus 4.8(1356)之后,是非 Anthropic 系最强。更值钱的是经济学:Fable 5 平均 $31/任务,Opus 4.8 $10.40,GPT-5.5 xhigh $3.68,GLM-5.2 只要 $2.40——约 Fable 的 1/13。
架构上靠的是 IndexShare:在 MLA、DSA 之外把稀疏注意力的 top-k 索引跨层复用,压低了 100 万 token 上下文的推理成本。整体 753B 参数 MoE(每 token 约 40B 激活)、MIT 许可、28.5T 预训练、1M 上下文。
Z.ai 自己放话,年内可能见到"开源的 Fable 级模型"。如果差距按这个速度收窄,"谁是前沿"这个问题的答案会从一家公司变成一群实验室。
AINews · Artificial Analysis
前线·开源模型·前沿信号
Poolside 开源 225B 编程模型 Laguna M.1:Apache 2.0、256K 上下文——主打长程 agent 编码,不是跑分
法国 Poolside 把 Laguna M.1 权重以 Apache 2.0 开源,256K 上下文。结构是 70 层稀疏 MoE:总参数 225B、每 token 激活 23B、256 个专家、top-k=16,明显冲着长程 agent 编码优化。
给本地玩家看的演示:3-bit MLX 量化在 M3 Max 128GB 机器上跑到约 26 tok/s、峰值内存约 100GB。
一周内开源侧冒出 GLM-5.2、Laguna M.1、North Mini Code 三条线——编程 agent 的开源底座从"缺人用"变成"挤破头"。
AINews · Poolside
前线·开源模型·前沿信号
转折
27亿美元买回来的Transformer之父又走了——去了对手公司
Noam Shazeer——2017年那篇"Attention Is All You Need"的共同作者——在Google工作二十多年后,跳到OpenAI。他2024年因$27亿Character.AI收购回归Google,成为Gemini联合负责人。现在他走了。Transformer之父跳到了正在准备史上最大IPO的对手公司——他自己的声明说:"It was a difficult decision to move on. I'm incredibly proud of the amazing team at Google."但事实是:Google花了27亿买回来的人,半年后又走了。
- 2017年"Attention Is All You Need"共同作者
- 从Gemini联合负责人到OpenAI架构研究负责人
- 中间经历了$27亿Character.AI收购回归
前线·具身智能·数据采集·人的选择
机器人缺数据——有人专门叠T恤和搬箱子赚AI实验室的钱
XDOF在杭州干一件脏活:雇人叠T恤、搬箱子、拧螺丝,一遍遍重复,让机器人学。不是模拟数据——是真人真手真物。AI实验室已经在付钱让他们做。创始人说:"这不是什么光荣的工作,但没有脏数据就没有干净模型。"XDOF用GELLO遥操作系统采集数据,已积累13万条轨迹。跟Nvidia的ENPIRE形成了有意思的对照:ENPIRE让AI自己写训练代码——但训练数据还是得有人来叠衣服。
- 真人真手真物采集,不是模拟数据
- 已积累13万条操作轨迹
- 总部杭州,服务全球AI实验室
前线·具身智能·数据采集·人的选择
四个MIT年轻人做了四次反直觉判断——三年做出了SaaS史上增长最快的软件
Michael Truell,25岁,父母都是记者。15岁做编程游戏拿了一万美元奖金,18岁参加投资人测试——一个小时的题他十分钟交卷,做完反过来给投资人出了一道题,投资人花了更长时间才解出来。他和三位MIT同学Aman Sanger、Sualeh Asif、Arvid Lunnemark2022年开始创业,做了四次反直觉的判断:
第一次——从解决方案倒推问题。先知道AI能把编程变成什么样,从终点往回走。Truell说:"这违背创业常理。但AI领域充满新可能,或许不必局限细分问题,可以着眼宏大愿景从那里起步。"
第二次——先失败一年,然后做自己真正热爱的事。他们觉得编程领域竞争太激烈(微软做Copilot,十几家在抢),跑去做了机械工程的3D CAD自动补全。结果CAD数据比代码数据少几个数量级,他们不是机械工程师。几个月后放弃,转回去做编程——逃离竞争不如直面竞争。
第三次——不做插件,做编辑器。从界面到底层架构完全重构。Truell说:"如果编程会从根本上改变,界面必须改变。"相当于说:我不在别人的画框里画画,我自己造画框。
第四次——先不碰模型,先把产品跑起来。一开始完全买外部API把编辑器做出来,被质疑"不掌握核心模型不是受制于人?"他的回答:先把编辑器做出来让更多人用,用户一多数据自然就来。
四次判断,每次都押在自己最懂的领域。24个月内从零到40亿年化收入,没有任何B2B SaaS公司完成过这样的跨越。然后SpaceX以$600亿股票收购了他们——Cursor需要算力训练自己的模型,SpaceX手里有55万块GPU。算力才是最终的议价筹码。
创造·创业融资·创造力的代价·人的选择
声音
"Anthropic 允许自己用最强模型做前沿研究——前沿继续推进,权力失衡继续加剧。"
—— Jeremy Howard,fast.ai 创始人
声音·力量转移·经济学翻转·对AI的理解变了
"软件工程是三明治——AI压缩了中间的执行层,但两端的决定层和交付层抵抗自动化,且这种抵抗不会被能力提升克服。"
—— Arvind Narayanan & Sayash Kapoor,Princeton 教授
声音·力量转移·经济学翻转·对AI的理解变了
今日小结
今天的五条新闻连成一条线:AI正在从屏幕里走出来,进入物理世界。Nvidia实验室半夜AI自己教机器人装GPU,成功率99%——人早上来只看报告。Midjourney从猫图跳到全身扫描仪——从生成图片到扫描人体。
XDOF在杭州雇人叠T恤教机器人学——脏数据才是具身智能的瓶颈,模型再强也得有人来叠衣服。
另一条线:创造力判断比经验更快。四个MIT年轻人做了四次反直觉判断——从解决方案倒推问题、先失败再做热爱的事、不做插件做编辑器、先跑产品再训练模型——三年做出SaaS史上增长最快的软件。
Transformer之父$27亿买回来又走了——去了认为还有值得做的东西的地方。AI独兽兽创始人平均年龄从40降到29——这个时代第一次让年轻人的判断力比传统经验更有价值。
小结·力量转移·瓶颈倒逼
Be Curious 🌌
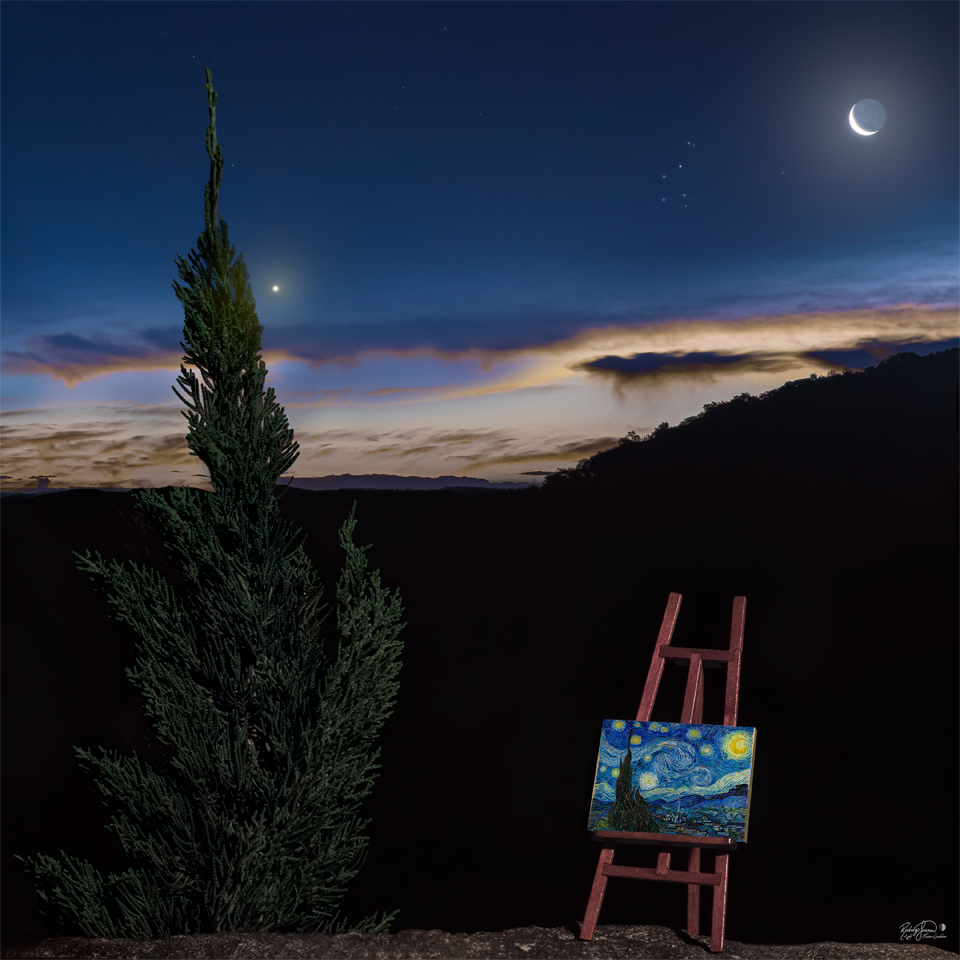
Starry Night II · 星夜 II · 摄影师 Rodrigo Guerra 在巴西Cascavel用长曝光还原了梵高1889年看到的同一片星空——一棵大树、新月、金星,前景画架上摆着梵高原版《星夜》· NASA APOD · 2026-06-19
真实天空比画更美。每天我们从宇宙深处回望,保持好奇,持续探索。查看原文 →
好奇·星云