国内第一次完全依靠国产算力完成训练与推理全流程的万亿参数大模型,今天正式开源。
美团宣布开源 LongCat-2.0,总参数 1.6 万亿,平均激活约 480 亿参数,使用 MIT 许可,可在 5 万张国产算力卡集群上全流程跑通。
华为昇腾、Moore Threads、MetaX 等国产芯片厂商已确认支持。
这远不止一个展示品—LongCat-2.0 以匿名身份「Owl Alpha」在 OpenRouter 上跑了两个月,成为平台上使用量最大的编程模型之一,SWE-bench Pro 得分 59.5,超过 GPT-5.5 的 58.6 和 Claude Opus 4.6 的 57.3。
对于日常写代码、搭 Agent 的人来说,这意味着一个 MIT 许可、接近顶尖水平、而且成本极低的选择出现了。
OpenRouter 上 LongCat-2.0 定价:输入 $0.75 / 百万 token,输出 $2.95 / 百万 token,远低于闭源旗舰。
- 美团 LongCat-2.0,1.6 万亿参数 MoE,MIT 许可
- 5 万张国产卡集群(华为昇腾)训练,首次纯国产卡跑通万亿模型
- SWE-bench Pro 59.5(超 GPT-5.5),匿名跑两个月已是 OpenRouter 热度前几
- 支持 100 万 token 上下文,Agentic Coding 定向强化
- 定价:$0.75 入 / $2.95 出 每百万 token
GLM-5.2(ChatGLM 团队)在 Artificial Analysis 智能指数中登顶开源权重榜,与 GPT-4o、Claude Sonnet 等头部闭源模型的得分差距已缩至个位数。
MIT 许可 + 百万 token 上下文,Nathan Lambert 称之「众多可信开源替代里的第一个—很像当年 DeepSeek R1 的那个时刻」。
- Artificial Analysis 智能指数登顶
- MIT 许可,百万 token 上下文
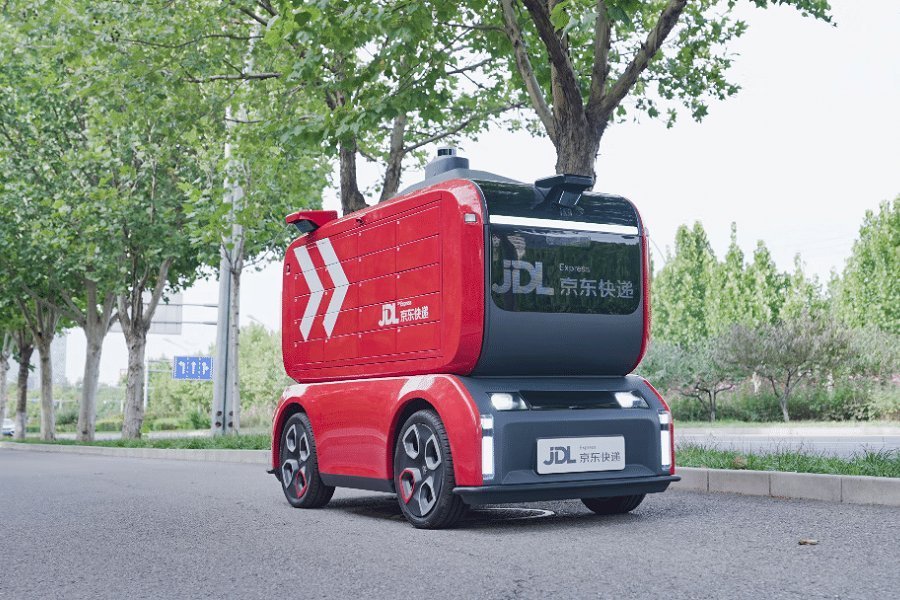
据英国《金融时报》报道,京东 CEO 刘强东警告:公司 70 万配送人员将被机器人取代,凸显快速自动化已成为中国本就严峻的就业市场的新威胁。
京东已与约 120 所学校签署协议,对配送工人进行再培训,使其转型从事机器人维修保养等新岗位。
北京已将追踪 AI 对就业的影响列为国家优先事项。 这一信号不止于京东:Amazon 此前同样通过机器人避免未来雇佣 60 万人。
从 DoorDash 到 Uber 再到 Mercado Libre,配送/物流行业的「机器替代人」正从假设走向可量化的时间线。
- 70 万配送工面临替代,已启动 120 校再培训协议
- 北京:追踪 AI 就业影响 = 国家优先事项
- 对比:Amazon 通过机器人避免雇佣 60 万人
腾讯发布混元 Hy3:295B 总参数、21B 激活的 MoE,192 专家 top-8 路由,256K 上下文,附 3.8B MTP 投机解码层,采用 Apache 2.0 许可。
许可变化才是这次发布的重点:旧的社区许可以把韩国、英国、欧盟排除在外,Apache 2.0 一次性全部放开。
发布当天 vLLM 就原生支持,腾讯的生产级内核直接进 vLLM 主线—混合长度解码吞吐最高提升 2.95 倍,TTFT 降约 24%。
Teknium 随即把 Hy3 在 Nous Portal 免费开放两周。
社区立刻把它和 GLM-5.2 摆到一起比:有人判断腾讯若实测达标将挤进开源第一梯队,也有人坚持 GLM-5.2 仍是”实际最好用的开源模型”。开源前沿的天花板在一个月内被抬高两次,竞争重点已经从榜单分数转向部署稳健性。
腾讯混元 Hy3 开源:295B 模型第一天就能跑在 vLLM 上,许可比参数更值钱。
Anthropic 发表研究:Claude 内部存在一个”全局工作区”样式的结构,集中在很小一撮激活上,他们称为 J-space。
核心主张不在”思维链提取”,而在于识别一个特权内部表征层—它可被报告、可被调节、参与灵活推理。
为什么研究圈震动:Neel Nanda 称之为”工作记忆机制迄今最好的证据”,Lindsey 认为理解这个特权空间可能是理解 LLM 认知的关键。
实用角度更直接—研究称它能提前暴露隐藏概念、检出提示注入、在言语化之前暴露内部”破坏相关”特征。它给出的是审计和干预模型的抓手,不是哲学命题。
争议也随之而来:Anthropic 的宣传框架用了”意识”字眼,被批评者指为过度主张。
社区用 CKA 相似度在 38 个开源模型里对比,发现层/深度组织高度普适—跨 Llama 和 OLMo 这种不相干家族都成立。
无论”意识”之争如何收场,一条新的干预路径已经被打开,这才是这篇研究的分量所在。
General Intuition 与 Kyutai、Epic Games 发布 MIRA,一个可游玩的多人世界模型:在 1 万小时机器人自采数据上训练,实时 20fps 运行,5B 参数就能在单张 B200 上完整跑一场 2v2 对战,全程没有显式物理或渲染引擎。
看点不在画面多好,关键在世界模型从”生成一段像视频的片段”变成了”一个可交互的模拟器”—你控制车,模型负责整个世界规则。
当世界模型能实时交互,游戏、机器人训练、自动驾驶仿真的底层规则都要重写。
MIRA:5B 模型在单张显卡上实时跑《火箭联盟》,世界模型第一次能玩。
「Tokenmaxxing(一味堆 token)已经彻底过时了。」
— Simon Willison(独立 AI 开发者 / 研究者)· 7/3 · Simon Willison Notes
「GLM-5.2 是众多可信开源替代里的第一个—很像当年 DeepSeek R1 的那个时刻。」
— Nathan Lambert(Interconnects)· 近日 · Interconnects
Gartner 数据:仅 17% 组织实际部署了 AI Agent,超 60% 计划两年内部署;预计到 2027 年底逾四成 agentic 项目将被取消。Agent 的能力在涨,放进生产系统是另一门功夫。
Gartner Hype Cycle 2026
AI 工具已将用户暴露在垃圾内容下的概率降低 20%,每天撤销近 200 万 fake votes,拦截 2300 万 spam views。平台正在用 AI 对抗 AI 生成的操控行为。
Reddit / The Verge
英国央行副行长 Sarah Breeden:越来越强的 agentic 系统可能需要更专门的监管框架,涉及 guardrails、circuit breakers 甚至 kill switches,尤其针对 payments 和 trading 场景。
Reuters · 06-30
AI Mode 在烹饪查询中把原始 recipe 链接连同图片、评分和食材数量重新前置展示,AI 搜索开始承认不能把内容源彻底吃掉。
The Verge
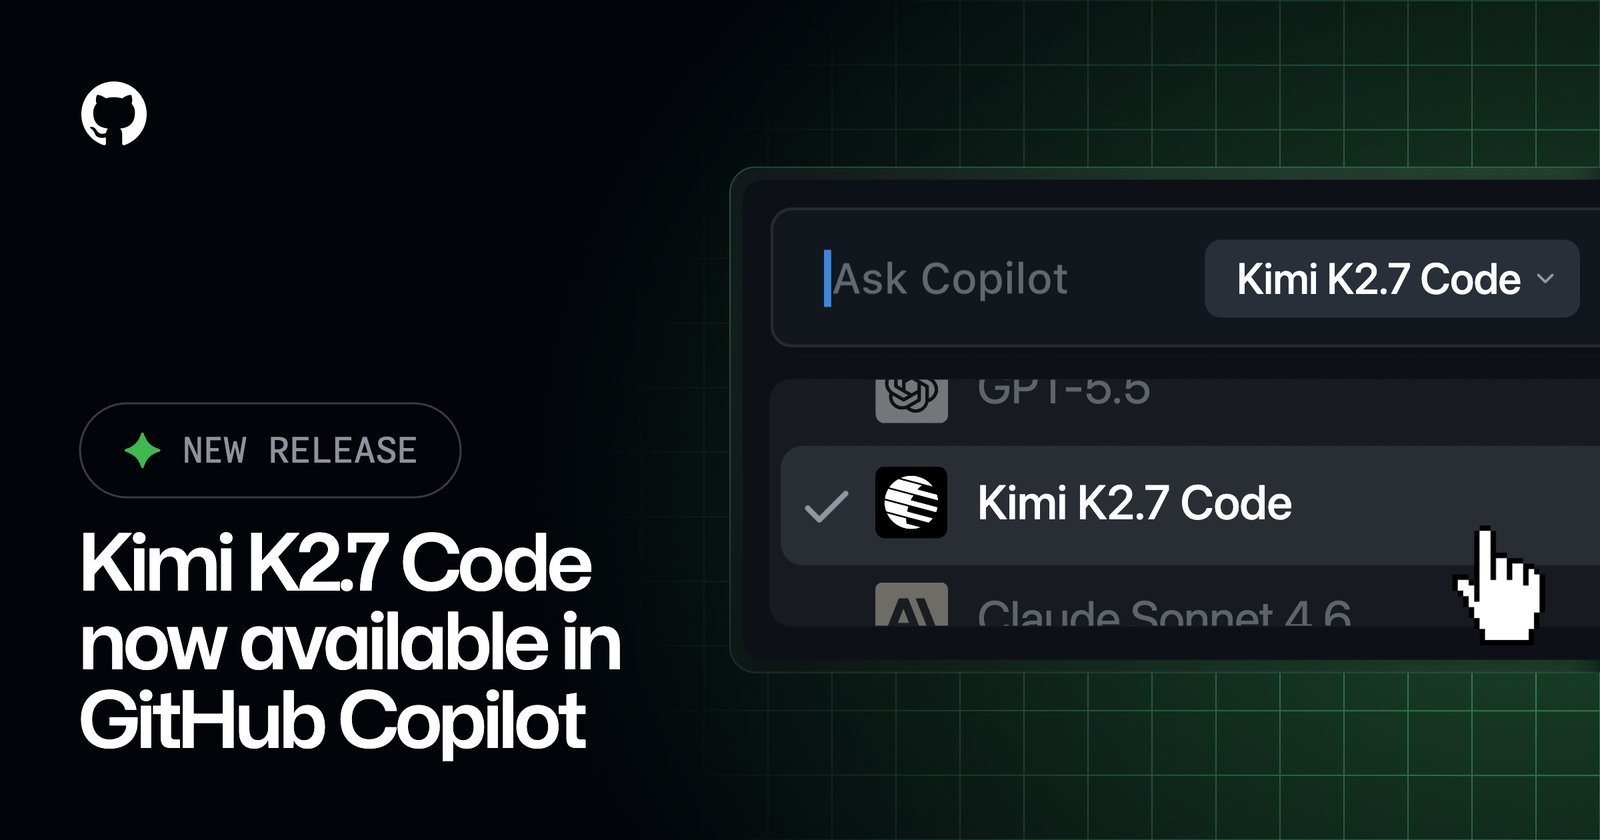
GitHub 宣布 Kimi K2.7 Code 作为 open-weight 模型在 GitHub Copilot 中正式 GA。
这是 Copilot model picker 里第一个 open-weight 模型可选项—开发者第一次可以在 Copilot 主界面选择开源模型,不再只限 OpenAI 或 Anthropic 闭源选项。
这对开发者的真实影响:模型选择权出现在正式产品界面里,不再是极客手工切换。
GitHub 明确表示这是「更多选择和更低的成本选项」。
Moonshot 的 Kimi K2.7 在 coding benchmark 上表现出色,创业团队和个人开发者可以用更低成本获得接近一线水平的代码辅助。
- 模型:Kimi K2.7 Code(Moonshot AI)
- Copilot model picker 中第一个 open-weight 选项
- 由 GitHub 托管在 Microsoft Azure
- 先向 Pro/Pro+/Max 开放,Business/Enterprise 默认关闭
用 AI 批量产出网文,曾被视为提高生产力的捷径。但读者受够了。
番茄小说(字节跳动)已限制每日可发布字数,仅 6 月就拒绝了超过 10.4 万篇「低质量」投稿;晋江文学城创始人黄艳明明确要求作者仅限用 AI 做研究和校对,并请读者举报疑似 AI 写作的文章。
导火索是质量失控。
读者在小红书上截图分享小说中间残留的 AI prompt 词、奇怪的比喻和 AI 腔句式。
一位读者说:「读到一个快速生产的东西,就是在浪费我的时间。」
但另一边,北京开发者马浚贤搭建的 InkOS(多 Agent 小说自动写作系统)已有 5 万+ 下载量,有人靠 AI 生成的小说赚到了钱。
- 番茄限每日字数,6 月拒绝 10.4 万低质量投稿
- 晋江要求作者 AI 仅限辅助,欢迎读者举报
- InkOS 多 Agent 写作系统 5 万+ 下载
- 核心问题:AI 是生产力还是垃圾制造机?
峡谷里的地质史,比任何模型训练都久。

Grand Canyon, Arizona, USA · NASA · 36.06°N, 112.14°W
看了一天 AI 的新闻,地球上还有不需要 GPU 冷却的地方。山川湖海,让我们保持好奇、继续探索。