GPT-Live 不是一个更强的模型发布—它改变了你打开 ChatGPT 时面对什么。OpenAI 7 月 8 日正式推出新一代语音模型 GPT-Live,ChatGPT Voice 的底层模型从附属功能升级为默认交互模式。
GPT-Live-1 成为 Plus/Pro 用户的默认语音模型,GPT-Live-1 mini 成为免费用户的默认选项。
GPT-Live 支持边思考边说话、随时打断、在后台委托推理模型处理复杂任务、以及屏幕共享与视频分析。
Sam Altman 的自我坦白很直接:「我一直更喜欢打字而不是对着 AI 说话。
现在我觉得这要变了。」
这可能是 2026 年最安静但也最深远的产品变化之一:当 10 亿 用户的默认交互从键盘变成麦克风,入口本身就在改写人机交互的基线。
- GPT-Live-1 / GPT-Live-1 mini 即日起覆盖 iOS / Android / Web
- 付费用户默认 GPT-Live-1,免费用户默认 mini
- 支持打断、语音中接力推理、屏幕共享
- API 即将开放,开发者和企业可申请
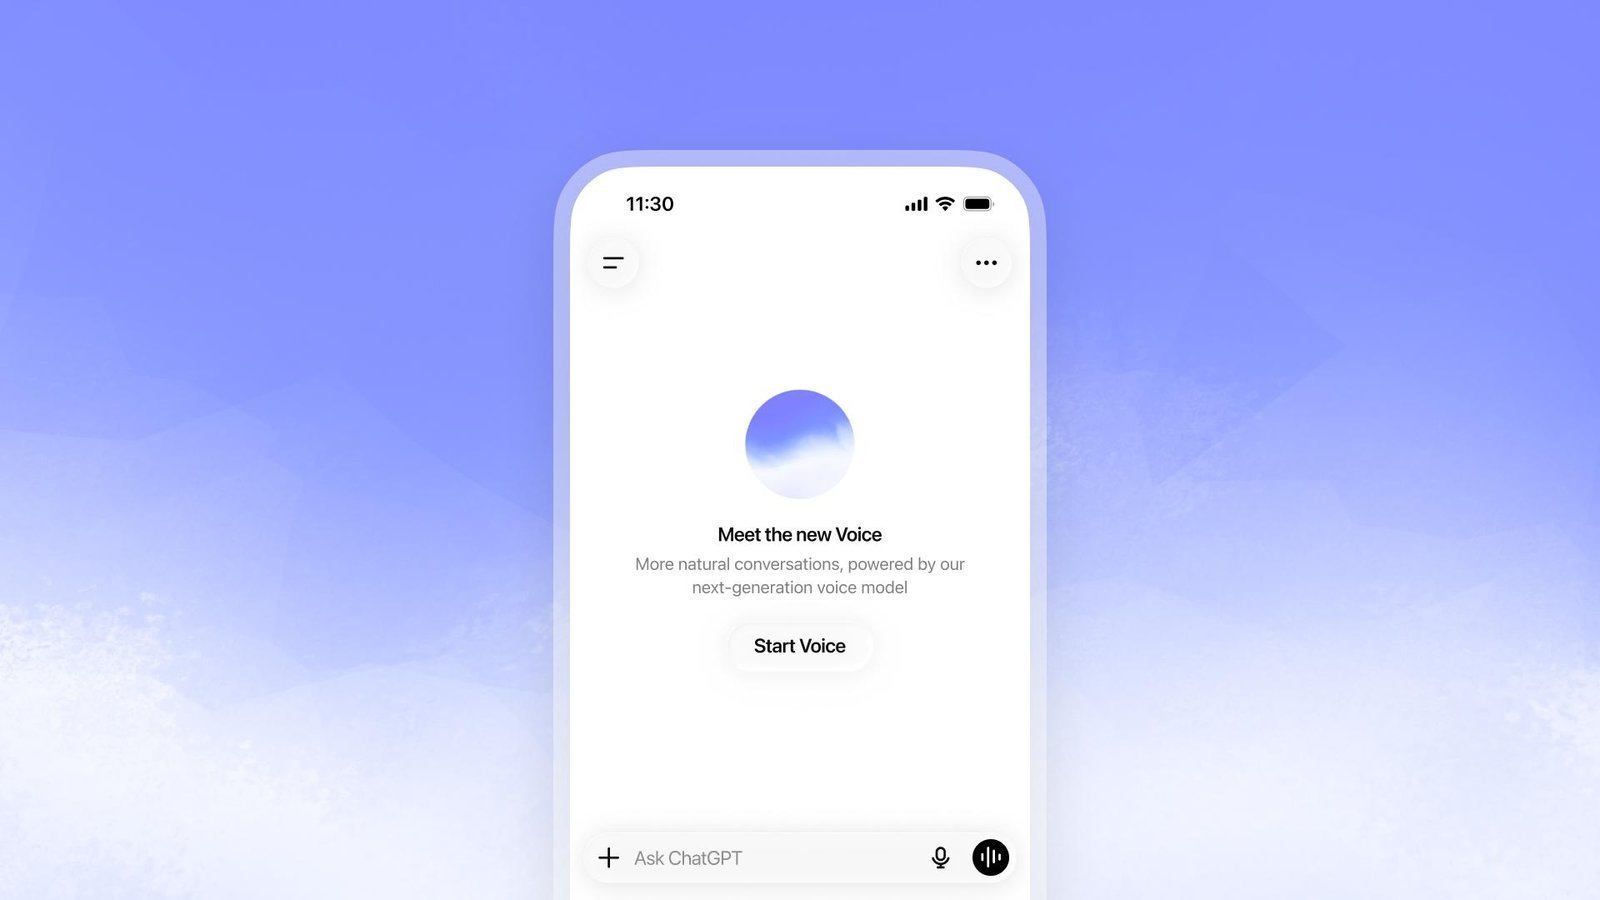
把 Voice 升级为 ChatGPT 的默认入口。
Mistral 今天正式踏入具身 AI:它从零训练了一个专门的机器人导航模型,没有把通用 LLM 硬塞进机器身体。Robostral Navigate 是一个 8B 参数模型,只靠单颗 RGB 摄像头引导机器人穿越复杂环境—不需要 LiDAR、深度传感器、多摄像头阵列。
在业界标准 R2R-CE 排行榜上,Robostral Navigate 在未知环境的导航任务中达到 76.6% 成功率,超过最好的多传感器方案 4.5 个百分点。
纯模拟环境训练(60 万条轨迹 × 6000 个虚拟空间),配合在线强化学习持续迭代—Mistral 称「未看到任何平台期」。
更重要的是产业信号:欧洲最强 AI 实验室把军事级别的单摄像头导航能力做到开箱可用—轮式、足式、飞行机器人都能跑。
这意味着仓库、工厂、物流场景的自动化门槛正在下降。
- 8B 参数,单 RGB 摄像头,无需 LiDAR / 深度传感器
- R2R-CE 76.6%,超多传感器方案 4.5%
- 纯模拟训练 60 万条轨迹,在线强化学习持续优化
- 适用轮式/足式/飞行机器人,面向工业自动化
Mistral 发布 Robostral Navigate:单摄像头 = 不用 LiDAR。
Muse Image 是 Meta Superintelligence Labs 的首个图像生成模型,7 月 7 日正式上线。
它没有做成独立的 Web 应用,直接嵌进了 Instagram Stories 和 WhatsApp—这是十亿级用户的日常界面。
在 Instagram Stories 中,Muse 驱动超过 30 种 AI 特效(胶片质感、纸雕风、粘土动画、16 位游戏角色);在 WhatsApp 中,用户可以在对话中直接输入文字生成图片。
还支持 @ 提及 Instagram 账号来生成包含该账号内容的个性化视觉—你可以把朋友「放」进一张创意插画里。
信号很清楚:Meta 没有在做一个「AI 图片工具」,它在把图像生成变成社交平台的原生功能层—就像滤镜曾经从第三方变成 Instagram 的一部分那样。
- Meta Superintelligence Labs 首个图像模型
- Instagram Stories 30+ AI 特效 + WhatsApp 内嵌图像生成
- 支持 @ 提及账号生成个性化内容
- 日常创建免费,超额订阅制
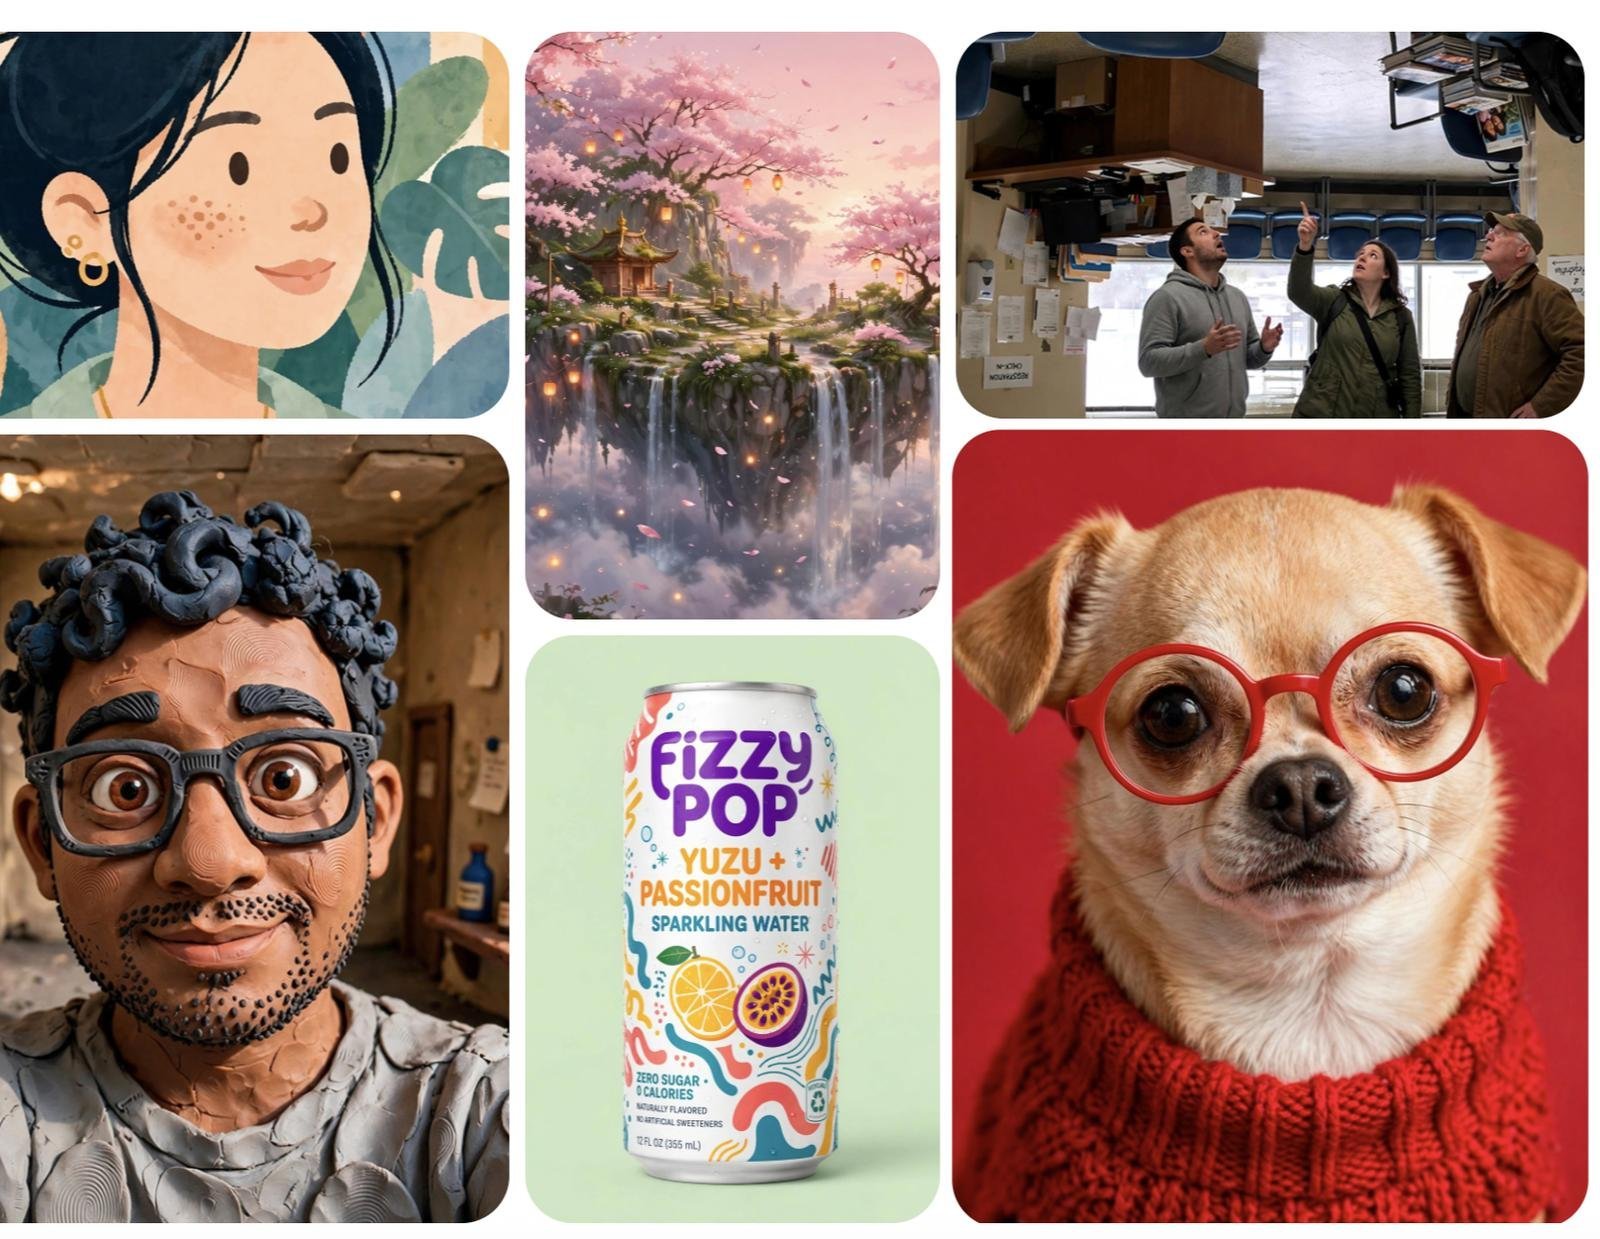
Meta Muse Image 进入 Instagram Stories 和 WhatsApp。
xAI(SpaceXAI 品牌)发布 Grok 4.5,官方定位”首个专为编码与 agent 训练的模型”,与 Cursor 联合训练。
Musk 的说法是”Opus 级,但更快、更省 token、成本更低”。
参数规模 1.5T,是 Grok 4.3 的 3 倍—这是 xAI 首次进入真正的旗舰编码 agent 级别。
定价是最狠的一刀:每百万 token 输入 $2、输出 $6,对比 GPT-5.6 的 $5/$30 和 Opus 4.8 的 $5/$25。
缓存命中再打 75% 折到 $0.5。
上下文窗口 500K(原 Grok 4.3 是 1M 视觉输入)。
在 Artificial Analysis 智能指数上排第 4(54 分),比 Grok 4.3 高 +16。
真正的杀手锏是效率:每个智能指数任务成本 $0.31,每任务输出 token 约 1.4 万、比 Opus 4.8 低 60% 以上;Coding Agent Index 任务总 token 量 190 万,Fable 5 是 720 万。
当”接近最强但便宜一大截”成为常态,编码 agent 战争的赢法不再只看谁最强,而看谁让同样的活花更少钱。
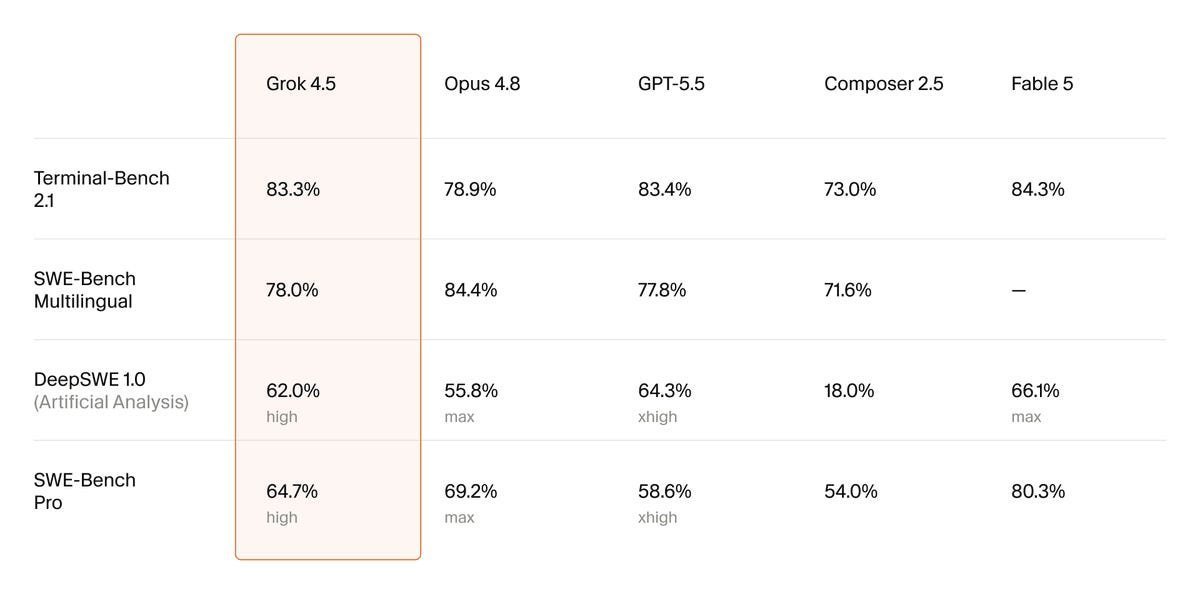
Grok 4.5 发布:1.5T 参数的\“Opus 级。
模型,定价却只有 Opus 的零头。
HF 趋势榜上一个叫 lingbot-vision 的项目(GitHub 485 星)做了件朴素的事:它不靠海量人工标注,改用「边界建模」学亚像素级的空间表示。说人话—它让模型对物体的边缘和远近更敏感,进而改善深度估计,服务具身智能体。
与其说它在「认出这是什么」,不如说它在学着「丈量空间」。
当机器人要伸手、避障、落脚时,这种对「深浅」的感知往往比认物体更要紧。
普通人能拿来干嘛:给自己的机器人或视觉应用接上更稳的深度感知,少一截「撞墙才知道有墙」的笨拙。
「GPT-live launches today. it feels magical and real.。」
— Greg Brockman · 前沿实验室 CEO · 7/8 · 前沿实验室 Blog
「那些『10倍AI辅助工程师』,眼下大多是海市蜃楼。」
— 《Line of Departure》· 美国军事刊物 · 2026 夏季刊 · Line of Departure
这周最容易被忽略的趋势,藏在三个发布的交集里。前沿实验室 把 GPT-Live 做成 ChatGPT 移动端的默认入口;Cursor 在 6 月底推出了 iOS 版(在手机上启动 Agent、看实时进展、合并 PR);Notion 7 月 8 日上线了专门的 Agents iOS 应用—它独立于主 Notion 应用,是一个专门的 AI Agent 聊天中心。
三件事发生在同一周,方向完全一致:AI 工具竞争正在从「谁的模型更强」变成「谁更容易被触达」。你不再是坐到电脑前才能用 Agent 干活—掏出手机、按下语音、AI 就在那里。
这个转变对开发范式的影响,可能比下一个模型的 benchmark 数字更深远。
- GPT-Live:ChatGPT Voice 默认入口,手机端优先
- Cursor iOS:在手机上启动/跟踪/合并 Agent 工作
- Notion Agents iOS:独立 AI Agent 聊天中心,支持多模型
AI 入口正在从桌面挤进手机:GPT-Live / Cursor / Notion Agents。
Google 把「视频后期」从剪辑软件里抽出来,做成了一个按钮。Video Remix 用 AI 在几秒内把普通视频片段重混成可分享的短视频—不需要剪辑技能,普通人也能做出带感的成片。
这是消费级创作工具的典型斜率:能力不新,但门槛没了。
当「重混一段视频」和「滤镜一键套用」一样简单,更多人会开始产出,而不是只看。
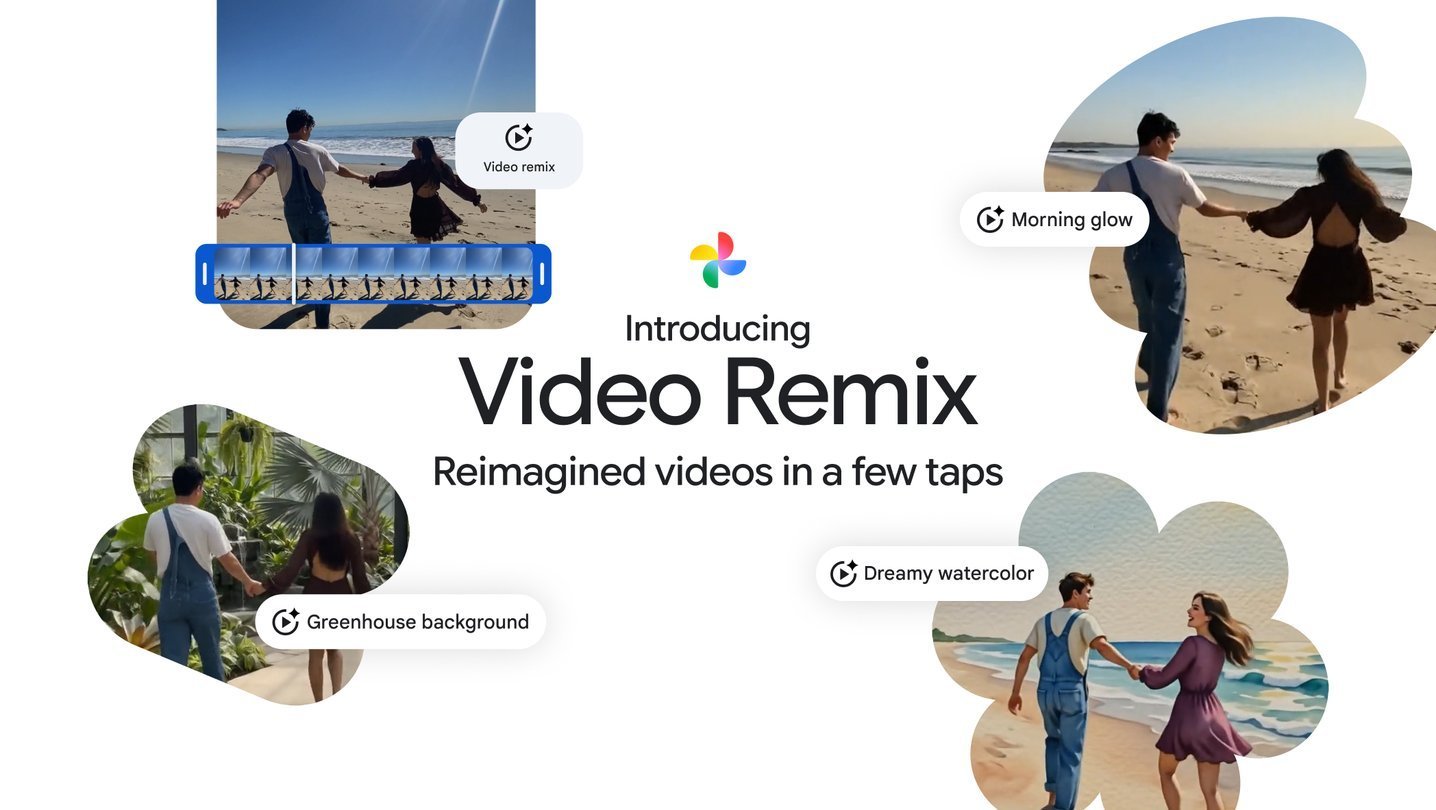
Google Photos Video Remix:把视频后期做成一键功能。
阿里 Wan 团队发布的 Wan-Streamer v0.2,把视频生成从「交任务、等结果」变成了「边做边看」。同等延迟下做到更高分辨率的流式输出—模型不再一次性吐出整段视频,画面边生成边播放,创作者能实时看到画面长出来。
这对短视频、直播、游戏过场是实时的:创作者不再等渲染完才看结果,画面边生成边播放,调整的反馈循环被压到了肉眼可感。
生成视频第一次有了「直播感」。
流式视频生成:画面边生成边播,创作者不再等渲染。
今天看起来互不相关的几条新闻,拼出一张资本分流图。
一边是 Physical AI:Mistral 发布机器人导航模型(技术落脚点)+ SambaNova 融资 10 亿美元做推理芯片(基础设施)+ AGIBOT 第 15000 台下线(量产兑现)—钱在往「让 AI 长出身体」的方向汇聚。
另一边是 AI 的屏幕化:Meta 把 Muse Image 铺进 Instagram 和 WhatsApp(社交触达)+ Google Photos 让用户一键重混视频(消费级工具)+ Notion 和 Cursor 向移动端迁移(工作流入口)。
AI 正在钻进每块屏幕里,变成用户最顺手的那一层界面。
这不是一个比另一个更好的问题。两条线都真实,都有钱在进场。
区别在于一条需要基础设施和硬件制造,一条需要产品设计和用户触达。
Physical AI 与「AI 屏幕化」—钱往两个方向跑。
缅因州的 V 形湖,比任何大模型参数都安静。
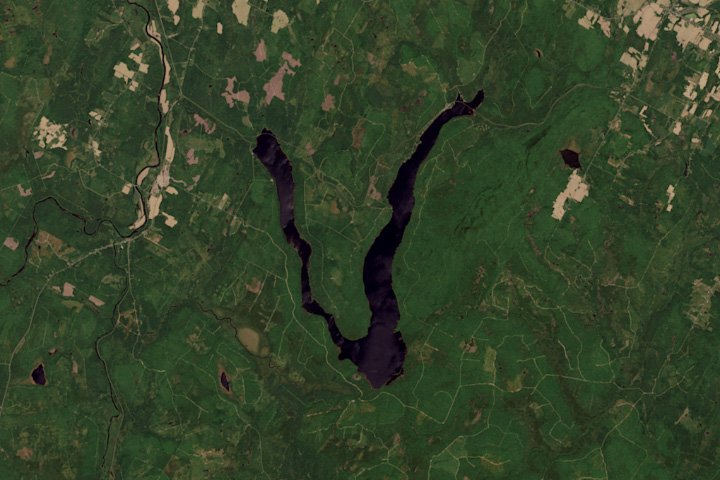
Scopan Lake, Maine, USA · 46.95°N, 68.28°W
Scopan 湖的奇特 V 形源于 1940 年代一座小型水坝的修建。
西臂较浅(3-6 米),北臂较深(12 米+)。
它是 NASA Landsat 字母寻宝的一员—天然卫星图上可以拼出自己的名字。
看了一天 AI 的新闻,地球上还有不需要 GPU 冷却的地方。
山川湖海,让我们保持好奇、继续探索。