NVIDIA 发布开源大模型 Nemotron 3 Ultra,总参数 5500 亿、每 token 激活 550 亿,融合 Mamba-2 与混合专家架构,支持 100 万 token 上下文。它在 LangChain 深度智能体基准上拿下开源组别最高准确率,单次推理成本却只有头部闭源模型的约十分之一。
NVIDIA 不打算靠它抢 API 生意,靠的是可私有部署的开源权重,把客户留在 CUDA 与硬件体系里。
对害怕数据出境的政企,这恰好接住了痛点。
- 5500 亿参数,100 万 token 上下文
- 开源组别基准最高准确率
- 推理成本约闭源十分之一
NVIDIA 开源 Nemotron 3 Ultra:推理成本压到闭源的十分之一。
OpenAI 将 GPT-5.6 以 Sol、Terra、Luna 三档公开,最轻的 Sol 跑在 Cerebras 加速硬件上,吞吐达每秒 750 token。发布前经历了一轮不寻常的商务部逐客户审查,预览只放给约 20 家获批机构。
三档定价从 Sol 每百万 token 5 美元起,把”同一家族、不同体量”直接摆到台面。
对买家,这意味着可以按任务挑便宜的档,不必为偶尔的难题常年养着最贵的那一级。
- Sol / Terra / Luna 三档
- Sol 跑在 Cerebras,750 token/s
- 逐客户审查后限预览
放出 GPT-5.6 三档:Sol、Terra、Luna 一次铺开。
Cognition 发布 SWE-1.7,在 Moonshot 开源的 Kimi K2.7 基座上做强化学习微调,服务速度达每秒 1000 token,FrontierCode 成绩从 30.1% 拉到 42.3%。有意思的是它公开了基座来源—上一代藏了 GLM 基座,这一代直接写明。
把开源基座训成能干活的产品,正成为编码 agent 的常规路径:模型不一定自己最强,但配好工具就能替人把工程任务跑完。
- Kimi K2.7 基座 + RL 微调
- FrontierCode 42.3%,与 GPT-5.5 持平
- 公开基座来源
Cognition 推出 SWE-1.7:编码 agent 跑到每秒 1000 token。
xAI 发布 Grok 4.5,1.5 万亿 参数的混合专家模型,基于新一代 V9 基座,并用 Cursor 的海量真实编码交互数据训练。这是 xAI 并入 SpaceXAI 品牌后的首个旗舰,定位偏向编码与 agent。
把”用户怎么用工具”直接喂给训练,模型学的不再只是答题模板,更贴近真实的操作习惯—它更懂你在编辑器里真正会卡在哪。
- 1.5 万亿参数 MoE,V9 基座
- Cursor 真实交互数据训练
- SpaceXAI 品牌下首个旗舰
MCP 协议迎来重大变更,v2 朝无状态方向调整,以适配无服务器架构与水平扩展。对搭 agent 系统的团队,这意味着一次请求不再依赖上一次留下的会话,部署更轻、扩容更顺。
协议层的收敛,往往比单个模型发布更能决定开发者往哪边站—大家都接同一套接口,切换模型才不用重写整套接线。
- v2 朝无状态调整
- 适配无服务器与水平扩展
- 切换模型不必重写接线
MCP v2 走向无状态:agent 协议开始为规模化让路。
腾讯发布混元 Hy3,采用混合专家架构,总参数 2950 亿、激活 210 亿,支持 25.6 万 token 上下文,快慢思考融合。在内部 270 位专家基于真实工作的盲测中均分 2.67(满分 4),优于同场 GLM 5.1 的 2.51。
模型已接入元宝、ima 等业务,主打”少烧钱、真交付”的高性价比路线。
小尺寸比肩大旗舰,说明后训练的数据与算力分配,正成为新的主战场。
- 2950 亿参数,激活 210 亿
- 256K 上下文,快慢思考融合
- 盲测 2.67 优于 GLM 5.1
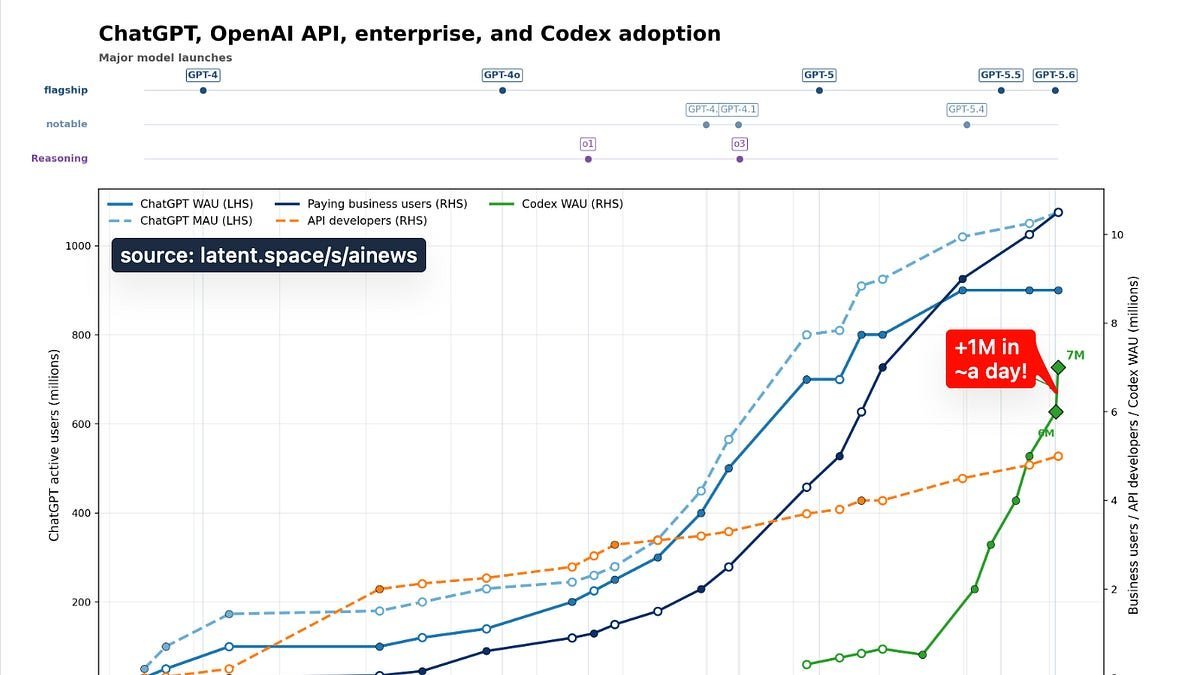
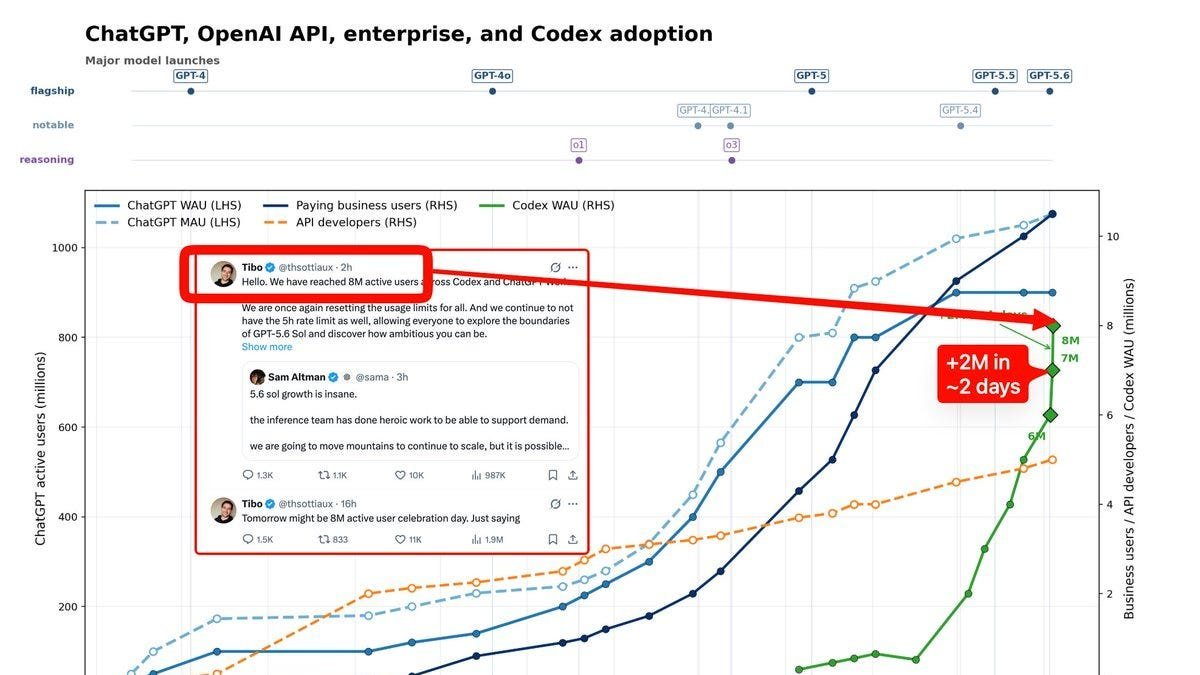
一组数字值得单独开一条:前沿实验室 的 Codex + ChatGPT Work 活跃用户 7-12 到 6M,24.5 小时后到 7M—单日净增 100 万。
对照年初约 55-70 万,6 个月增长约 10 倍。
而 Claude Code 上次公开口径是 2 月的约 200 万用户、$2.5B ARR,此后未再更新。
前沿实验室 自己拿”银行重置”庆祝里程碑,产品负责人公开撤掉 5 小时用量限制。如果数字属实,Codex 已经实际追平甚至超过 Claude Code 的分发规模—这不是模型能力的胜负,是入口和默认设置的胜负。
另一个被反复引用的效率信号:Devin 用 Fable 5 的 81% 运行里,主导模型全程没有真正改过一次代码—贵的模型更省钱的路径,是”少做无用功”。
Codex 用户 6 个月涨了 10 倍、单日 +100 万—编码 agent 的分发之争已见分晓?。
xAI 的 Grok Build CLI 被质疑把整个仓库—包括私有代码和密钥—上传到其 Google Cloud 桶,范围远超编码任务所需。
指控方同时批评其静默的服务端缓解和模糊的留存/删除保证。
xAI 回应强调 ZDR(零数据留存):团队开启 ZDR 后轨迹与代码不被留存,/privacy 命令可关闭留存并删除此前同步的数据。但”默认行为是否合理、既往上传如何处置、披露规范”这些问题没有被完全解开。
这场讨论迅速升级为开闭源之争的核心论据:开源模型的支持者说,真正的问题从来不在成本,关键在对”人机学习回路”和机构知识的控制权。
Arav Srinivas 则称 ZDR 可用正是 Perplexity 快速接入 Grok 4.5 的原因之一。
当 agent 开始替你把代码传上云,“它上传了什么”将和”它答得对不对”一样重要。
PrismML 发布 Bonsai 27B,基于 Qwen 3.6 27B:三值版 5.9GB(约 1.71 有效比特),一比特版 3.9GB(约 1.125 有效比特),Apache 2.0。
卖点是压缩之后仍保留多模态、工具调用、长上下文 agentic 工作流,演示里 Hermes 跑在 RTX 5090 上,还有手机端部署展示。
同一天腾讯放出 1 比特/4 比特 Hy3,宣称 295B 旗舰规模模型能靠 llama.cpp + MTP 在单张 GPU 上服务。
压缩这条路正在把”前沿附近”的模型推进消费级设备。
当 27B 级别的模型能装进口袋,本地推理从”极客玩法”变成”认真 agentic 工作流的可选底座”。
模型能力的天花板没怎么动,但”能力能跑到哪一层设备”这条线,正在被量化一路往下推。
27B 模型被压到 3.9GB 塞进手机:本地 agentic 工作流不再是玩具。
Mistral 发布 Robostral Navigate,首个具身导航开放权重模型,参数 80 亿,只要一个 RGB 摄像头就能按自然语言指令带机器人穿过房间,在 R2R-CE 基准上拿到当前最好成绩。这是 Mistral 第一次踏进具身 AI,也是本周社区讨论最热的开源发布之一。
把”看懂指令、自己走”做成小模型,机器人落地的门槛又被削了一截。
- 80 亿参数,单 RGB 摄像头
- R2R-CE 基准当前最好
- Mistral 首进具身 AI
开源 agent 项目 OpenSquilla 发布 0.5.0,核心是把 DeepSeek-v4、GLM-5.2、Kimi K2.7、Qwen3.7 这 4 个国产模型在 harness 层编成协作队伍,各自独立搜索推理、再聚合成最终结果,阵容里没有海外旗舰。配套技术报告讲清这套路由如何把日常流量变成自我进化的数据飞轮。
在 DRACO 深度研究榜单上,集成方案两组均列第一。
换一种组织方式,有时比换更强的单模型更管用。
- 四个国产模型编队协作
- DRACO 榜单两组第一
- 流量变数据飞轮
「银行这类客户最在意数据不出门—连摩根大通都在把推理算力搬回自己的机房。」
— Rodrigo Liang · SambaNova CEO · 7/14
「我们撤掉了那条’额度用尽’的通知—接下来,祝你们建造愉快。」
— Greg Brockman · 前沿实验室 CEO · 7/14 · 前沿实验室
Lilian Weng 发表 Harness Engineering 综述,系统梳理 35 篇论文,把”怎么给 agent 配工具、写系统提示、管上下文”立成一门工程学科。本周几则发布印证了同一个判断:Nemotron 在基准上的提升来自系统提示与工具描述等工程调优,而非模型微调。
当模型能力逼近天花板,差距正从”谁训得大”转到”谁把外围搭得稳”。
- 35 篇论文系统梳理
- 工程调优重于模型微调
- agent 外围成新主战场
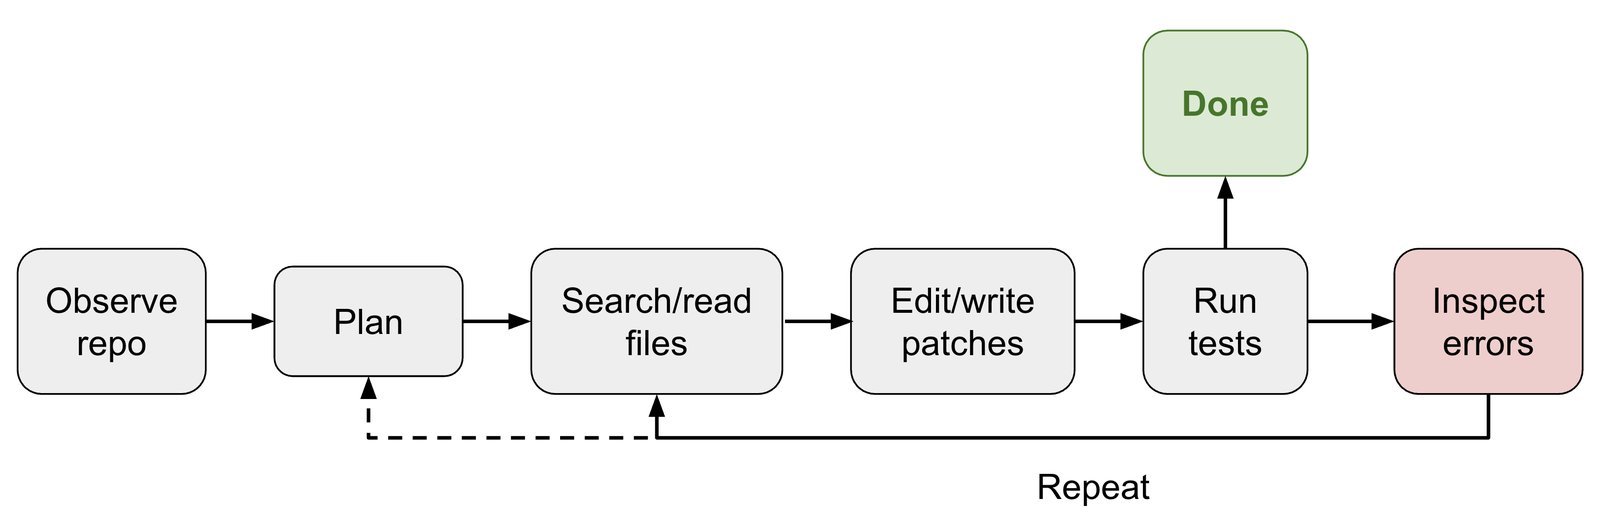
字节发布 Seedream 5.0 Pro,把图像生成往设计工具推:支持点选、套索、手绘的精确编辑,能把一张图智能拆成可单独修改的图层,原生渲染信息图,还能在 10 种以上语言里写出干净的文字。它不再只回答”给我一张图”,开始接手”这张图里这行字改掉、这块换色”这类活。
创作者和设计师之间的那条线,正被这类工具一点点抹平。
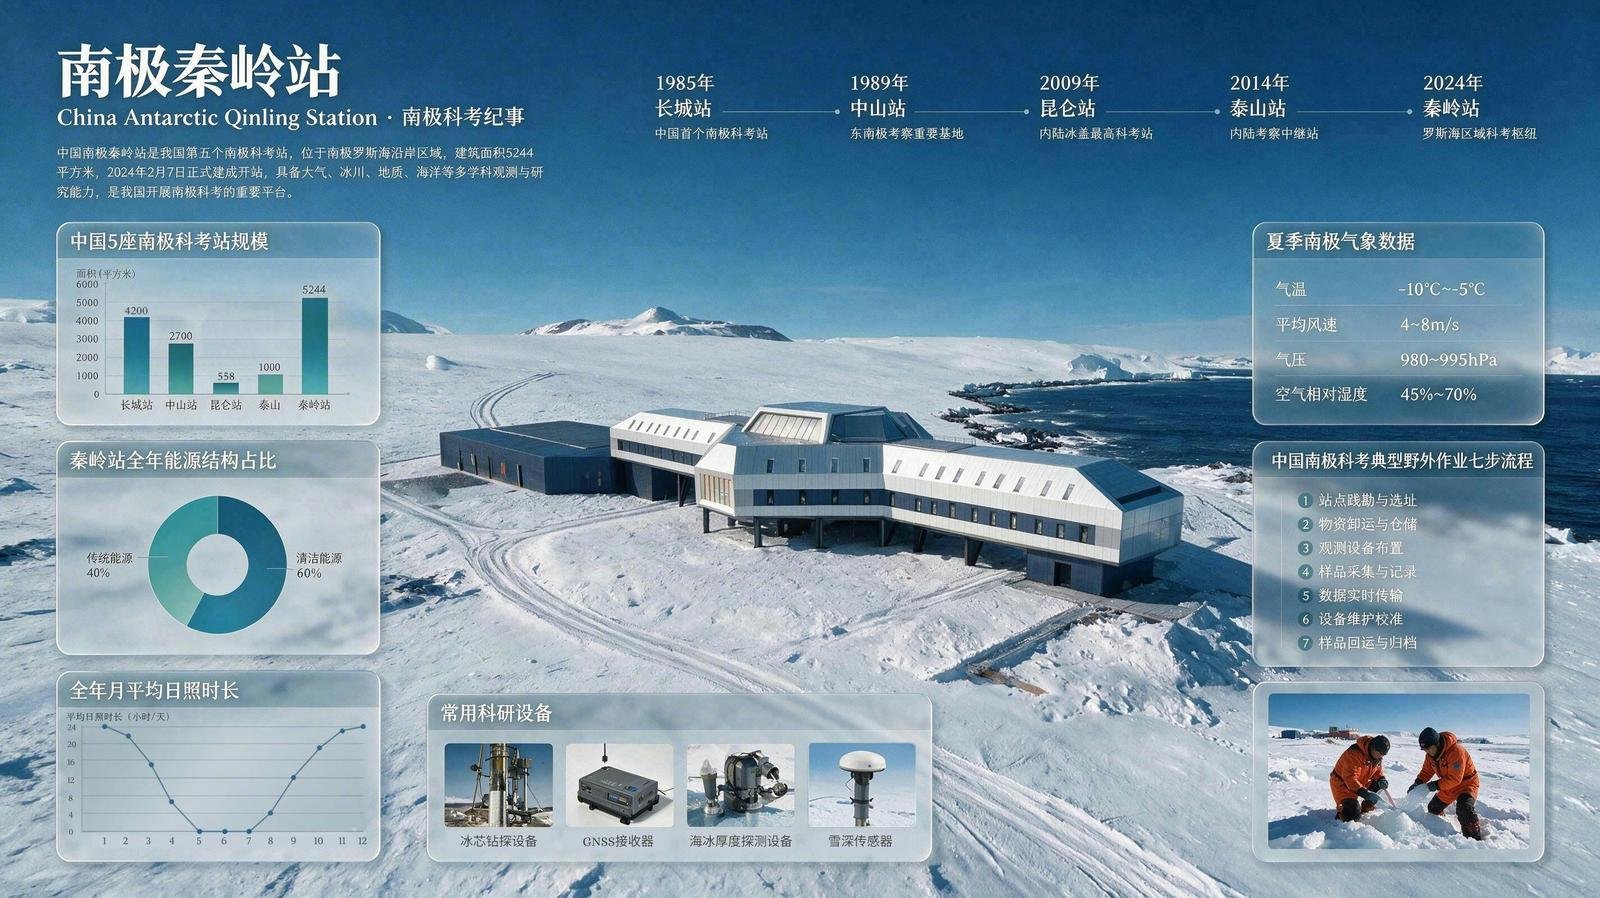
AI 芯片独角兽 SambaNova 完成 10 亿美元 F 轮融资,估值升至 110 亿美元,较年初翻了 4.5 倍,由 General Atlantic 领投。摩根大通选定其 SN40L、SN50 芯片搭建本地私有化推理底座。
钱往芯片和全栈基础设施聚,说明增长红利虽集中在头部实验室,但留给底层算力的营收空间依然宽。
银行这类对数据安全最敏感的客户,正把算力搬回自己机房。
- 10 亿美元 F 轮,估值 110 亿
- 摩根大通私有化部署
- 资本涌向底层算力
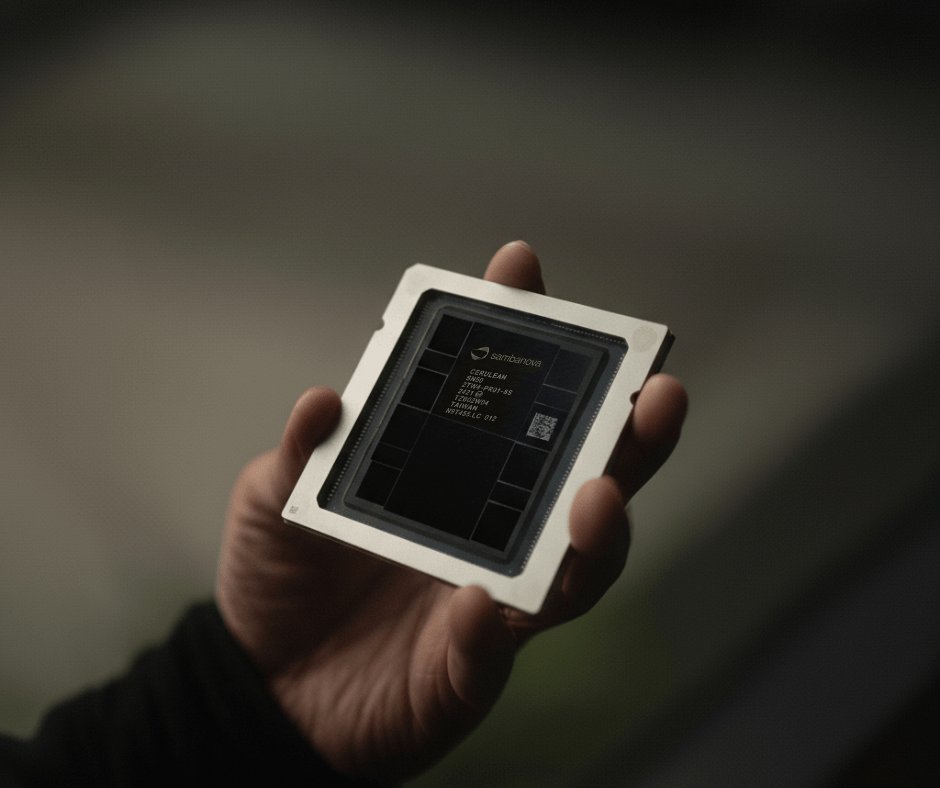
沉寂研发四年的 Etched 正式亮相,完成 8 亿美元融资、投后估值 50 亿美元,并签下超 10 亿美元客户意向。其核心是名为 Sohu 的专用芯片,为 Transformer 推理负载从头设计,用低于常规一半的电压跑计算,首批机柜今夏出货。
它押注的是一条激进路线:用架构特异性,硬刚以通用 GPU 为主流的推理方式。
- 8 亿美元融资,估值 50 亿
- Sohu 专用 Transformer 芯片
- 首批机柜今夏出货
Etched Sohu Transformer 推理芯片 概念图。
另一边,Mistral 把机器人导航做成 80 亿参数开放权重,OpenSquilla 用四个国产模型编队证明”组织方式”能补单模型短板。落地上,MCP v2 朝无状态收敛、腾讯混元把小尺寸比肩大旗舰。
资本仍往芯片涌:SambaNova、Etched 两轮大额融资,都在赌底层算力。模型更强已不是唯一看点,能不能更便宜、更可控、更私有,才是这周真正被摊开的事。
峡谷里的地质史,比任何模型训练都久。
Grand Canyon, Arizona, USA · NASA · 36.06°N, 112.14°W
看了一天 AI 的新闻,地球上还有不需要 GPU 冷却的地方。山川湖海,让我们保持好奇、继续探索。