同日的另一条暗线是关于「归属」:纳德拉提醒企业用专有模型付了两次钱,苹果智能靠阿里 Qwen 才落地中国,Meta 则因用 AI 排裁员名单被告上法庭。
模型更强已不是唯一故事。谁握着权重、谁握着数据、谁为算法的决定负责,才是今天被摊开的三件事。
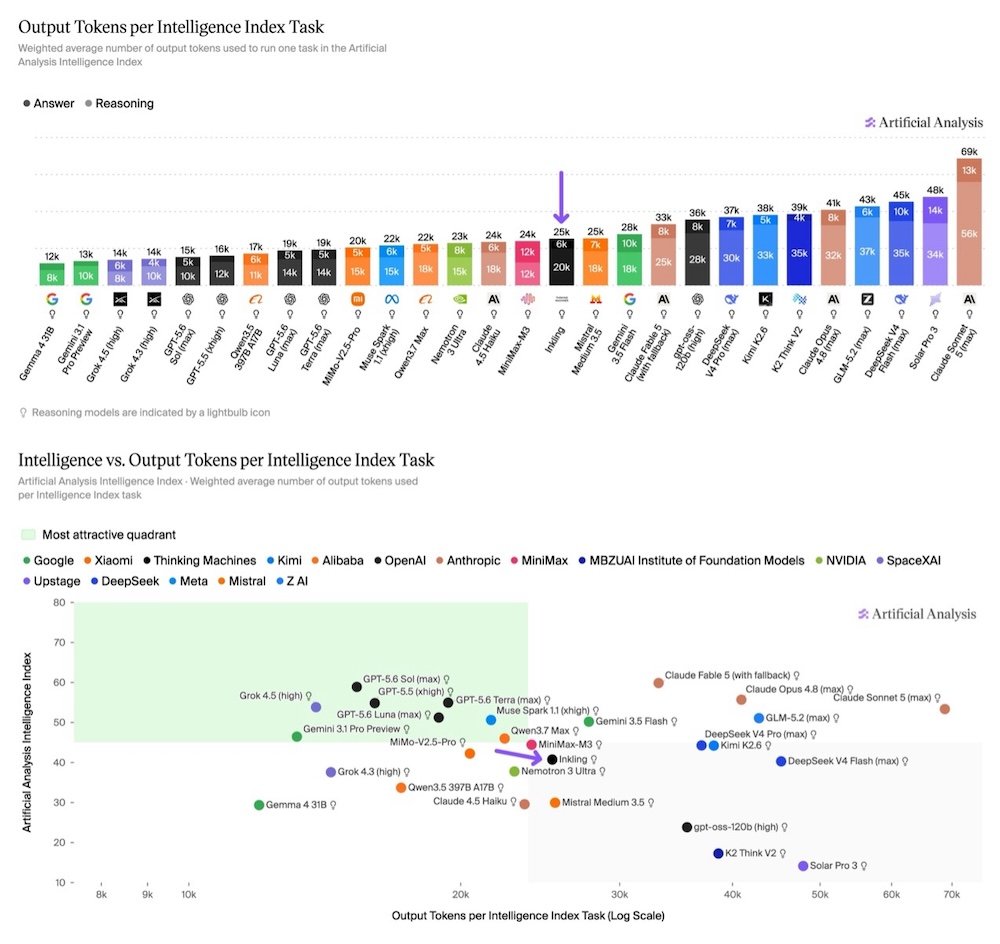
Mira Murati 的 Thinking Machines 放出首款完整开源模型 Inkling:9750 亿参数、每 token 激活 410 亿的混合专家架构,Apache 2.0 许可,45 万亿 token 多模态预训练,权重版上下文最长 100 万 token。第三方评测机构 Artificial Analysis 把它放上自家智能指数,得分 41,成为美国开源权重阵营的第一名,压过 NVIDIA Nemotron 3 Ultra 的 38、Gemma 4 31B 的 29、gpt-oss-120b 的 24。
但它不是今天最强的模型。同一份指数里,它仍落后中国开源阵营的 GLM-5.2 和 Kimi K2.6,也追不上顶级闭源。它是 TML 的「第一块基石」,不是「压轴旗舰」。
两个数据点值得单独说。一是效率:Artificial Analysis 测出 Inkling 每个智能指数任务平均只吐 2.5 万 output token,GLM-5.2 max 要 4.3 万、Kimi K2.6 要 3.8 万。二是定价:Tinker 上 64K 上下文输入每百万 token 1.87 美元、输出 4.68 美元。同场还预告了 Inkling-Small,2760 亿总参、120 亿激活。
上线当天生态就铺开了:vLLM 说 4×GB200 上最高跑到 380 token/秒/用户,NVIDIA 确认它是用 GB300 NVL72 训的。当最前沿的实验室也开始交权重、而且承认「我不是最强」,闭源与开源之间那层膜,又被戳破了一角。
中国监管批准 Apple Intelligence 在国内上线,但功能跑在阿里巴巴的 Qwen 模型上,而非苹果自有云模型,这是为满足本地合规要求做的取舍。此前苹果因模型与数据合规问题迟迟无法在华推出 AI 功能。
这给苹果解开一个关键市场,也把西方设备商对中国模型提供商的依赖摆到了台面上:想进中国,得借本地的脑子。
Apple Intelligence 获中国批准上路:跑在阿里 Qwen 上,不是苹果自己的云。
26 名在职与离职员工在加州联邦法院起诉 Meta,称公司用内部 AI 系统、键盘与活动监测、token 消耗仪表盘来打分排序、圈定裁员名单,而休病假、产假、育儿假或因残障产能下降的人,因积累不到有效考核数据被系统性选中。Meta 否认,称决定「由人作出,不是 AI」。
这不是第一起,但可能是最具体的一起,当算法替人做高利害决定,谁来审计它,成了躲不开的问题。
26 名员工起诉 Meta:用 AI 排的裁员名单,专挑休假的人。
一次安全漏洞曝出 Suno 的源代码中,似乎显示这家 AI 音乐生成公司从 YouTube 大批量抓取音频用于训练。Suno 本就面临音乐版权方的诉讼,这次给「生成音频是否建在未经授权的数据上」又添了一把火。
训练数据的归属,是生成式模型绕不过的老账,音频这条线,现在烧到了 Suno 身上。
宾夕法尼亚大学一名教授报告,用 GPT-5.6 Sol Pro 在约 90 分钟内推翻了关于 Benjamini-Hochberg 多重检验程序的一条已悬置数十年的猜想,此前人类尝试多年未果。结果尚待同行评议,若成立,是前沿模型产出原创数学结果的新一例。
模型从「复现已知」走向「给出新结论」,这条线一旦站稳,研究者的角色就要重写了。
Poolside 发布 Laguna XS 2.1 与 M.1 两款开放权重智能体编程模型:XS 2.1 是 33B MoE(每 token 激活 3B),小到能在单张桌面 GPU 本地跑;M.1 是 225B(激活 23B)的旗舰,面向长程软件工程。权重以 Apache/OpenMDW 放开,接进 Ollama、vLLM 等本地推理栈。
它把「写代码的模型」明确分成两层,轻量留本地,重的留云端,企业按需挑。
初创公司 PrismML 把一个 270 亿 参数的推理模型压缩到 4GB 以内,据称保留约 90% 性能,小到能在 iPhone 上本地运行;团队说 Apple 正在测试这套压缩技术。这是继一连串高效端侧模型之后的又一例。
推理模型第一次能塞进手机,意味着强模型不再必然绑定云端和联网。
「你为智能付了两次钱,一次付钱,一次交出让模型有用的专有知识。」
, Satya Nadella · Microsoft CEO · TechRadar
「前沿模型会留作实验和高价值任务,多数生产 AI 会转向开源或私有。」
, Clem Delangue · Hugging Face CEO
直播购物平台 Whatnot 收购机器学习公司 Shaped,把后者的实时个性化推荐基础设施直接并入自家市场,在直播过程中给观众推更对味的商品。这是消费平台「买而不是造」专业推荐 ML 的信号。
推荐这件事,正从大厂的自研护城河,变成可以买来的零件。
商汤发布并全面开源日日新 SenseNova-Vision 理解生成统一视觉大模型,用单一模型覆盖结构化视觉理解、稠密几何预测、图像分割与多视角 3D 几何四大任务,登顶 Hugging Face Any-to-Any 开源榜。过去这些任务各由独立专家模型负责,系统割裂。
对视觉创作者,意义在于不用再为不同任务维护一堆模型,一个底座对付开放场景,「缝合怪」时代的工具负担,被收进了一个模型里。
AI 编程初创 Emergent 完成 1.3 亿 美元 C 轮,估值跻身独角兽,距成立仅一年多,背后是约 1.2 亿 美元年化收入与 20 万+ 客户。在 agentic coding 赛道拥挤的当下,它用营收速度证明了这类工具变现不慢。
资本在用收入而不是 demo 视频,重新给「会写代码的 AI」标价钱。
今天的关键词是「归属」。
一边,Mira Murati 把 9750 亿参数的 Inkling 完整开放权重,开放阵营又多一个正统玩家。
一边,纳德拉提醒企业用专有模型付了两次钱,苹果智能靠阿里 Qwen 才落地中国。
Meta 因用 AI 排裁员名单被告上法庭,Suno 被曝拿抓来的 YouTube 音频训练。
模型更强已不是唯一故事。
谁握着权重、谁握着数据、谁为算法的决定负责,才是今天被摊开的三件事。
缅因州的 V 形湖,比任何大模型参数都安静。

Scopan Lake, Maine, USA · NASA · 46.95°N, 68.28°W
看了一天 AI 的新闻,地球上还有不需要 GPU 冷却的地方。山川湖海,让我们保持好奇、继续探索。