另一条线关于「谁在端侧跑模型」:苹果、华为、OPPO、vivo 集中备案,阶跃把原生智能体手机搬上了 WAIC 前夜。
资本也没闲着,SambaNova 拿下 10 亿美元;但更耐看的是 Google 和腾讯把「自己能跑的开源工具」又往前推了一步。
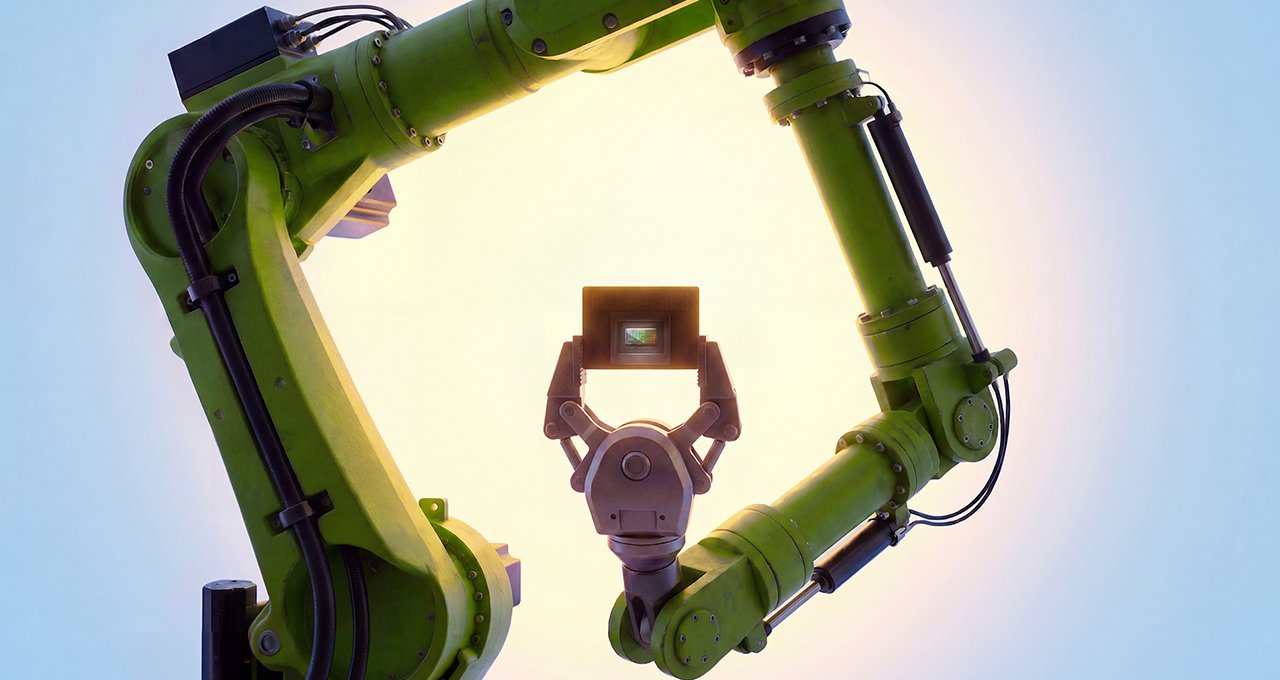
NVIDIA 发布 Jetson Thor 模组系列(T2000 与 T3000),把原本要给机器人用的 Thor 算力做成了可插拔模组。单模组算力约 2000 TOPS,能直接在机器狗、机械臂、工厂巡检设备上本地跑多模态大模型,不必把数据传回数据中心。
过去机器人「脑子在云上」,一断网就聋了;现在 NVIDIA 想把脑子焊进机身,整机功耗控制在 数千瓦 量级。这意味着「端侧具身智能」从演示视频走向产线配件,买块模组就能升级,不用重做整台机器。
- Thor 算力模组化,T2000 / T3000 两档
- 本地跑多模态大模型,断网可用
- 瞄准机器狗、机械臂、工厂巡检
多家手机厂商的端侧大模型在本周集中完成监管备案,包括苹果、华为、OPPO、vivo 的端侧智能功能。备案意味着这些模型可以在国内设备上合规调用,端侧助手从「实验室特性」变成「默认功能」。
另一边,京东的 Agent 与腾讯元宝打通,用户在京东里能直接调起元宝处理订单与售后。端侧的竞争从「谁的模型快」转向「谁的模型能合法地待在用户手机里」。
多家手机厂商端侧大模型集中备案。
阶跃在 WAIC 前夜发布 STEPX Neo,定位「大模型原生智能体手机」,系统层直接由智能体驱动,用户用自然语言就能让手机自己点 App、填表、跨应用串起任务。这不是把语音助手换皮,智能体直接被放在了操作系统的第一层。
同场还展示了多智能体协作:一个管规划,一个管执行,一个管核对。当手机出厂就带着「会干活的小队」,入口之争的战场从聊天框移到了整个系统。
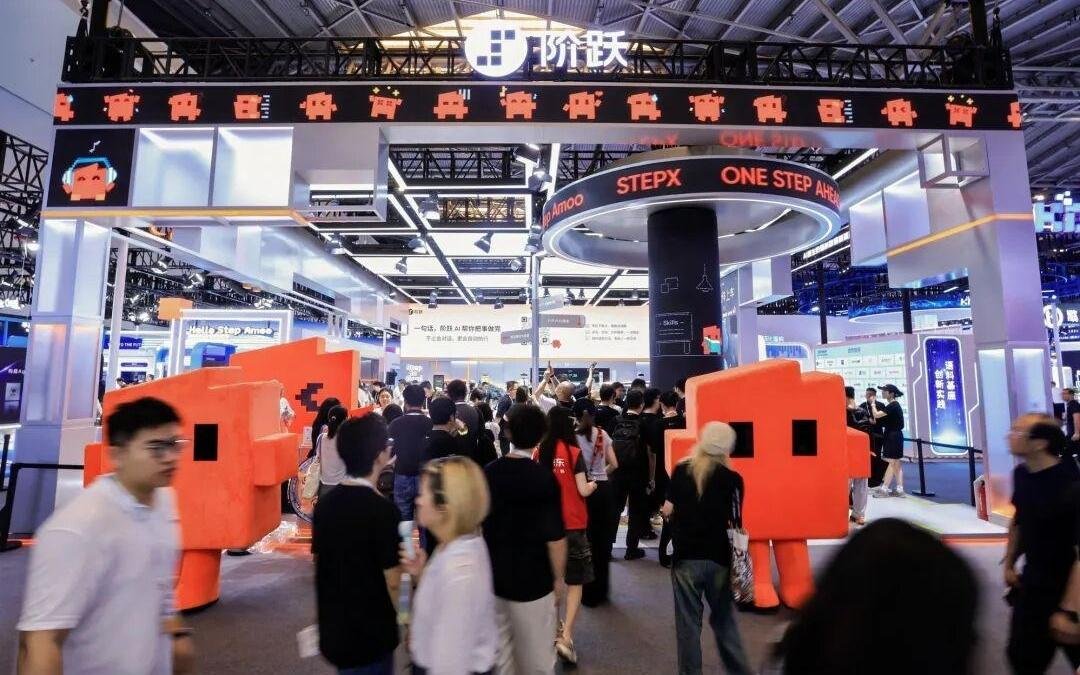
阶跃 STEPX Neo 大模型原生智能体手机。
进厂实习约一个季度的小米机器人,自攻螺母上件工站的双侧作业成功率从年初的 90.2% 提升到 98%,离人工作业 99% 的合格率只差一个百分点。它还解锁了两个新工站:中控台侧盖板排序和料箱折叠回收,成功率都到 90%。
更关键的是多机协同,多个机器人通过工厂系统同步节拍,稳定跑了起来。离「转正」就差那 1%,而这一步靠的不是更酷的演示,是成千上万次不出错的重复。
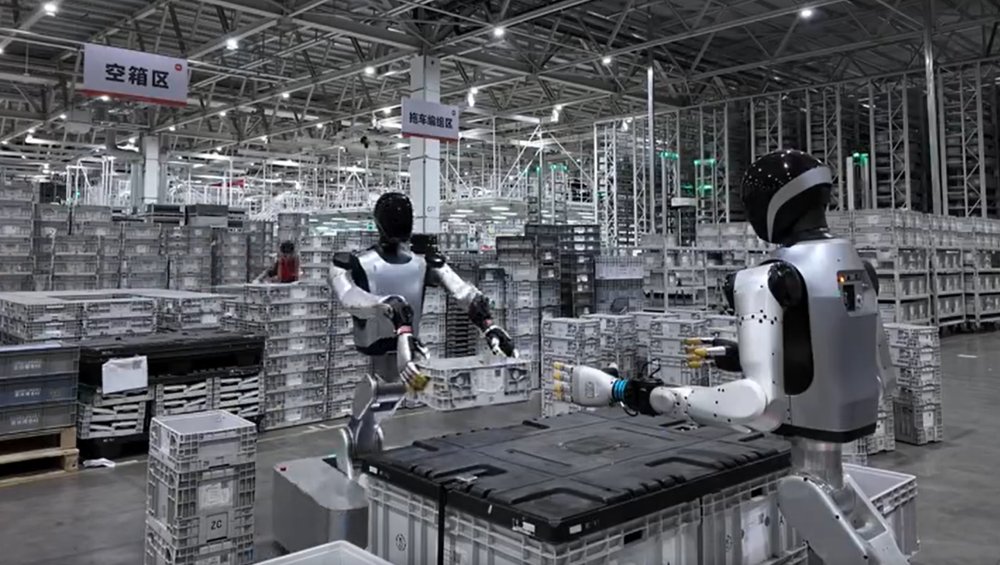
小米机器人多机协同作业。
月之暗面发布 Kimi K3,一个总参数 2.8 万亿、每 token 激活 1040 亿的混合专家模型,896 个专家每次只路由 16 个、上下文 100 万 token、原生多模态输入,并承诺 7 月 27 日公开全部权重。仅按参数规模,它就是史上最大的开源权重候选。
刷榜的第一站是编程。Arena 的前端代码竞技场里,K3 以 1679 分从 K2.6 的第 18 名直接登顶,压过 Claude Fable 5 与 GPT-5.6 Sol,这是开源模型第一次在「真人盲评」的前端工程任务里反超顶级闭源;成对胜率 76%,Fable 5 是 63%。
综合能力上也站到了第一梯队。Artificial Analysis 的智能指数给 K3 打 57 分,与 Claude Opus 4.8 持平,但官方自己承认「用户体验上与 Fable 5、GPT-5.6 Sol 还有明显差距」。成本是另一个卖点:输入每百万 token 3 美元、输出 15 美元,缓存输入再打 90% 折。
架构上它把注意力做成了「记忆」:Kimi Delta Attention(KDA)官方称在百万 token 上下文里解码快 6.3 倍,Attention Residuals 声称训效率提升约 25%。多个工程师当场把这次发布比作「开源界的 DeepSeek 时刻」。当 2.8 万亿权重承诺在十天后公开、而它已在前端工程上赢过最强闭源,开源与闭源之间的时间差,从「数月」被压到了「几周」。
月之暗面发布 Kimi K3 混合专家模型。
Google 开源 Agents CLI,一个在命令行里调度多步智能体的工具:给它一个目标,它自己拆任务、调工具、看结果、再决定下一步,过程全程留在终端。项目上线数天已收获 5100+ stars,面向想把 agent 编进脚本和 CI 流水线的开发者。
它把「智能体」从聊天窗口拉回开发者最熟的环境。当 agent 能像 grep 一样被写进一行命令,自动化才真正长进工作流里。
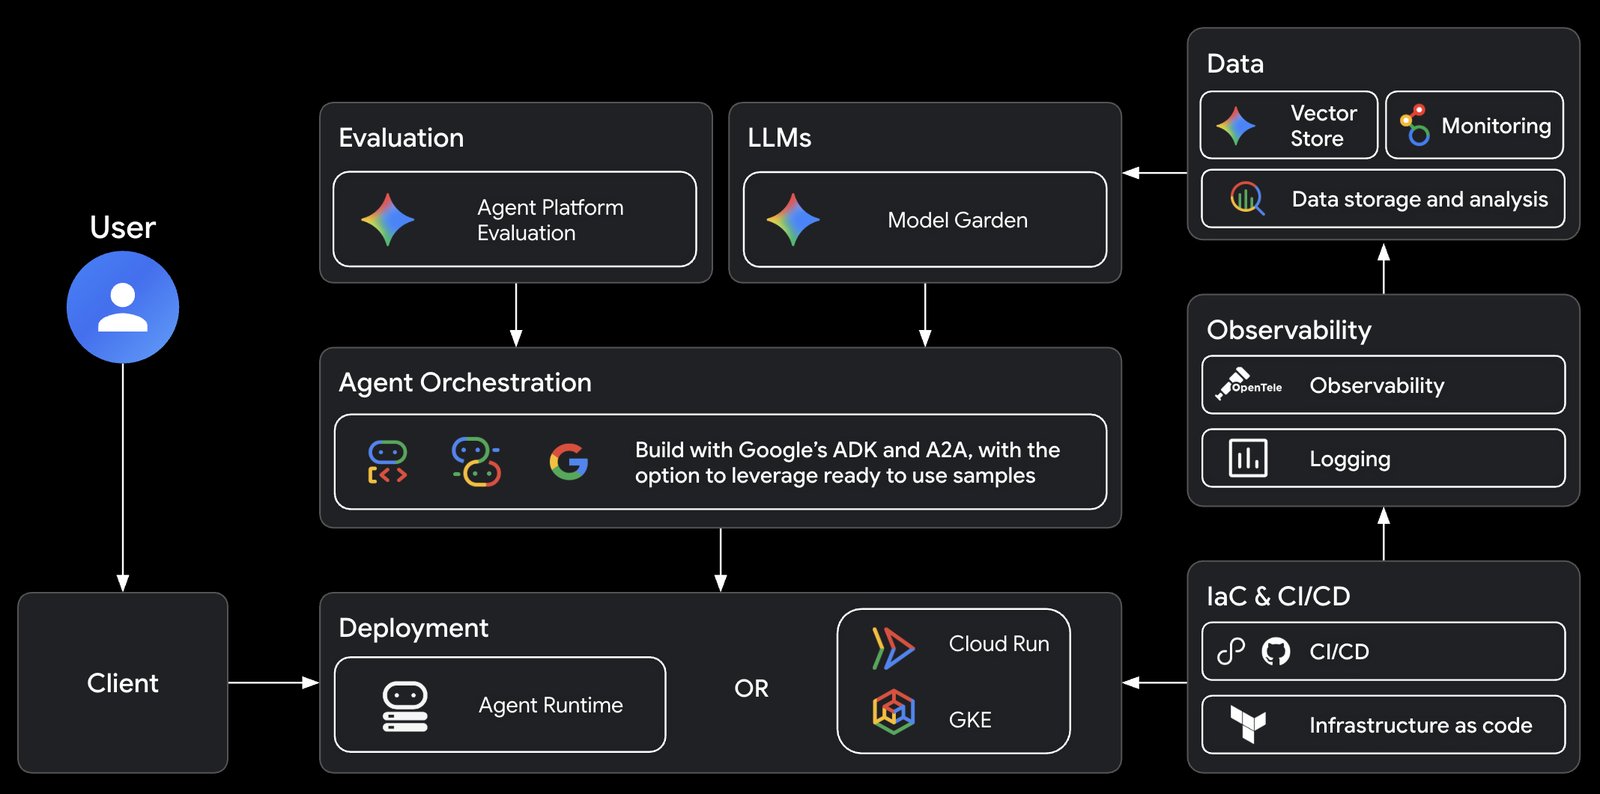
Google 开源 Agents CLI 终端智能体。
腾讯开源混元 Hy3 的量化版本,把 2950 亿参数的模型压缩到约 85GB,塞进单张高显存卡就能跑推理,权重与量化方案一并放出。对想在自己机器上部署大模型的中小团队,这是把「旗舰模型」从云上请下来的又一条路。
端侧与单卡可跑,正在从卖点变成底线。谁能把大模型压得又小又稳,谁就握住了私有化部署的门票。
「机器人真正的难点不在会不会动,在能不能一直做对。」
, Pieter Abbeel · UC Berkeley 机器人教授
「多数生产 AI 会转向开源或私有,前沿模型留作高价值任务。」
, Clem Delangue · Hugging Face
金山办公发布 WPS 灵犀专业版与 WPS Comate,把 AI 从「对话框」嵌进文档、表格、PPT 的编辑流程:选中一段数据就能让它写公式、做透视、生成汇报,长文档也能自动拆结构、补摘要。卖点不是「能聊天」,是「在你想改的那一行旁边就动手」。
办公软件的护城河,正从排版能力变成「替你把活干完」的能力。当工具开始理解你的文档而不是等你下命令,表格和幻灯片都成了可对话的对象。
字节跳动发布 Seedream 5.0 Pro,重点不在「更美」,而在「更准」:复杂构图、长文本里的多对象、以及科学场景(如南极科考站剖面)的几何一致性明显提升。给一段带尺寸和结构的描述,它能把建筑、设备、管线摆在该在的位置,而不是随手拼贴。
对视觉创作者,价值在「可控」,你交代得越具体,它越像在照图施工,而不是凭印象涂鸦。
AI 算力芯片与系统公司 SambaNova 完成 10 亿美元 F 轮融资,估值来到约 110 亿美元,资金主要投向自研推理芯片与面向企业的部署栈。在 GPU 供给仍紧的当下,资本在用钱投票给「非英伟达」的推理路线。
训练卡的格局已基本落定,推理卡的位子还空着。谁能把每次推理的成本压下来,谁就接住了接下来最大的那笔单。
今天的关键词是「落地」。
一边,NVIDIA 把机器人算力做成模组,小米机器人把打螺丝成功率做到 98%,具身智能从视频走向产线。
一边,端侧大模型集体过备案,阶跃把智能体做进手机系统层,Google 和腾讯把能自己跑的开源工具递到开发者手边。
资本也押了同一件事:SambaNova 的 10 亿美元,买的是推理侧那条还没被英伟达占满的路。
模型更强已不是唯一故事。
谁能合法地待在设备里、稳定地一直做对、便宜地跑起来,才是今天被摊开的三件事。
巴塔哥尼亚的安第斯山脉,在 2026 年南半球初秋被一层新雪勾出轮廓。
Snow in the Shadow of the Andes · NASA · 45.00°S, 72.00°W
看了一天 AI 的新闻,地球上还有不需要 GPU 冷却的地方。山川湖海,让我们保持好奇、继续探索。