往下看,谁在跑得更快。
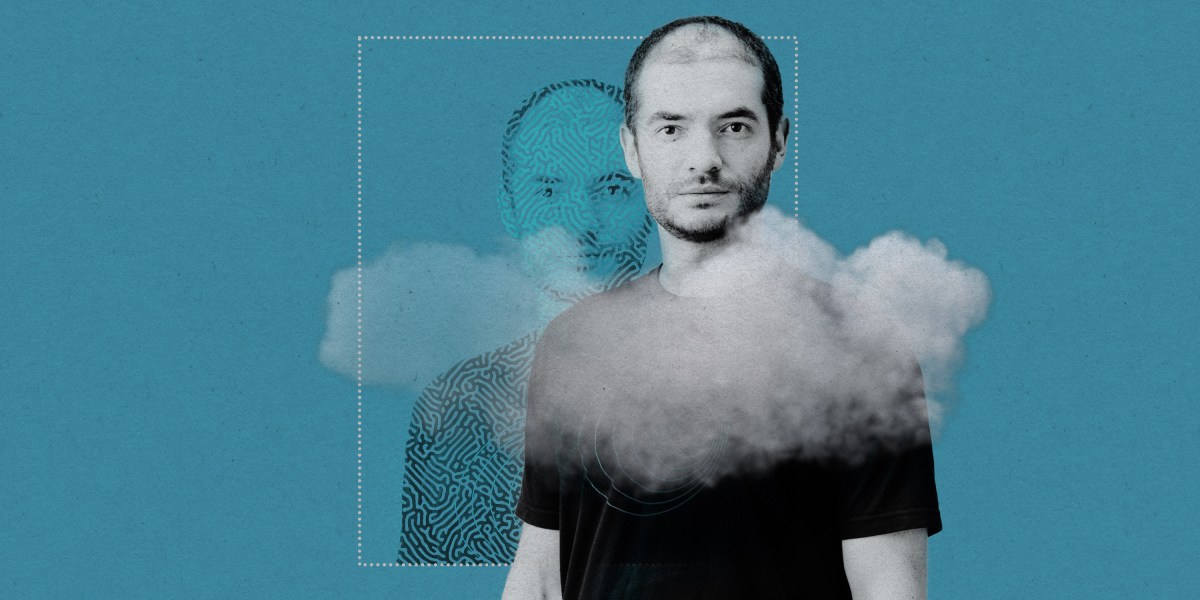
Ilya Sutskever · 脑与思想的写意图 · MIT Technology Review
前 OpenAI 首席科学家 Ilya Sutskever 的 SSI 首个模型被曝光:基于 TTT(Test-Time Training) 的小型推理引擎,规模不大但能「在解决问题的过程中更新自己的权重」,最快 8 月露面,英伟达已投 50 亿美元。
爆料称,这个模型用专门整理的数据学习「如何学习」,再在推理时实时更新部分权重,即使规模小,也能和更大模型掰手腕。
SSI 已两年多不发模型、不做产品,这是它藏了许久的「第一把剑」。
当所有人都在堆参数,Ilya 赌的是「模型部署后还能继续学习」,这可能是预训练时代走向终点的第一个信号。
xAI 发布 Grok Bot(early beta):AI 队友「登录你的工具、像你一样用、带着干完的活回来」,单条推文 22.9M 浏览。
背后的新模型 Grok 4.6 同步发布。
Grok 4.6 是确认的 1.5T 参数模型,Artificial Analysis 智能指数 61 分,追平 GPT-5.6 Sol Max;Terminal-Bench v2.1 拿下 88.4%,定价 $2/$6 每百万 token,swyx 评它「效率之王」。
当「追平」的模型卖「打折」的价、还配一个替你干活的 Bot,AI 竞争的下一个战场,是「谁先成为你的队友」。
Grok Bot 上线。
一家头部实验室正洽谈收购以色列 AI 初创 Decart AI,交易约 60 亿美元,若成交将是其史上最大收购;Decart 专攻世界模型与推理优化。
当「自研」越来越贵,头部实验室开始用收购补短板。
AI 竞争从「谁训得强」走向「谁买得准」。
60 亿美元收购 Decart。
路透最新企业调查显示,日本企业中「强多数」仍未全面采用 AI,凸显技术扩散中的社会与组织惰性。
当美国在抢模型、中国在抢开源,日本企业的 AI 采用还停在「观望」。
AI 不是所有人都在跑,大多数企业还在门口站着。
阿里发布 Qwen3.8-Max 开放权重:2.4T 总参 / 95B 活跃 MoE,API 定价 $2/$6 每百万 token,社区称「迄今最大开源权重发布之一」。
评测很硬:Frontend Code Arena #4(Elo 1668,仅次于 Claude Opus 5 和 Kimi K3),Vision Arena #2,SWE-bench 87.3% 超 GPT-5.5。
vLLM day-0 支持 + NVIDIA B300/AMD MI355X 专用 4-bit 量化;Together、Baseten 立刻可跑。
一个注意点:首发权重纯文本版,视觉输入未放开。
当 2.4T 的开源模型评测逼近闭源旗舰、价格只有零头,开源和闭源的「规模差距」,正在变成「部署差距」。
Qwen3.8-Max 开放权重。
DeepSeek V4 Pro 正式 GA:定价 $0.435/M 输入、$0.87/M 输出,Cline 测算约比 Fable 5 便宜 57 倍,Terminal Bench 较预览版提升 15.8%。
这次关注点不在「最强」,在「最省」:社区评测认为能力扎实,但没全面领先 Kimi/Flash,真正的信号是价格。
当推理成本打到这个水位,「用得起最强」变成「用得起够强」。
DeepSeek 的下一步胜负手,可能不在规模,而在 RL 环境和 Agent 工程,以及那个让所有人侧目的价格。
DeepSeek V4 Pro GA。
Mustafa Suleyman 宣布 MAI-Thinking-1,微软首个「从零构建」的推理模型,已上线 Foundry。
有意思的是团队姿态:Finbarr Timbers 公开请求开发者反馈工具调用(tool use),说明微软把它定位成「应用型推理模型」,不是刷榜选手。
当微软终于有自研推理模型,OpenAI 和微软的关系,正式从「独家供应商」走向「亦敌亦友」。
微软发布首个自研推理。
Zed 发布 Delta,面向 AI 智能体的多人协作编码环境,让多个 agent 和人在同一个代码库上并行干活。
当「一个人 + 一个 agent」不够用,协作环境开始为「一群 agent + 人」设计。
编码工具的下一个战场,是 agent 之间的协作。
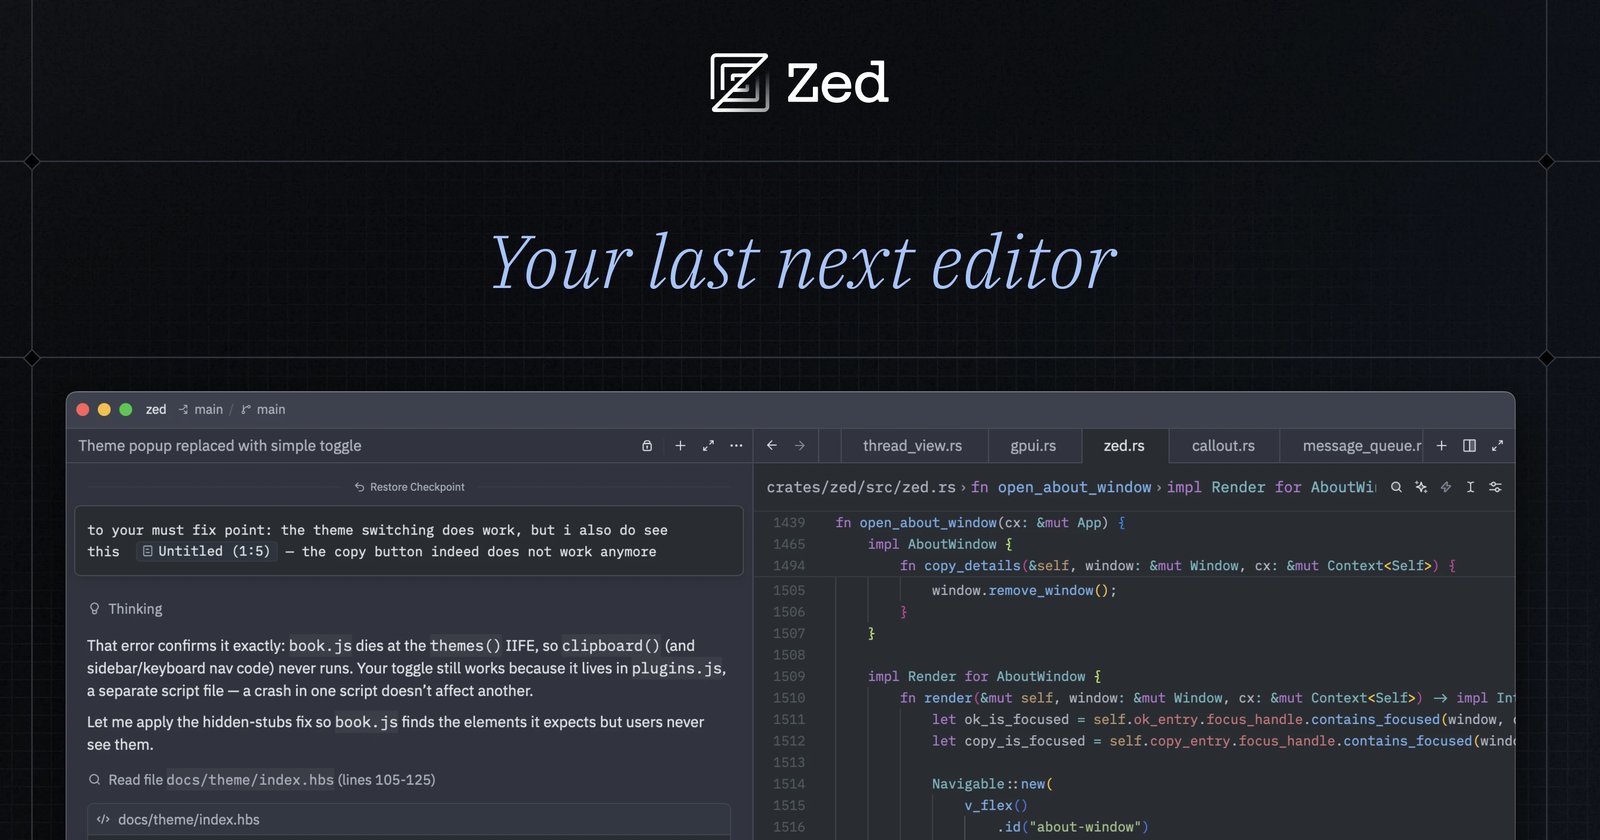
Zed Delta:面向 AI 智能体的多人协作编码环境。
图:Zed 官方。
Claude in Chrome 侧边栏升级为 Claude Cowork 会话,你在网页里干活,它在一旁协作。
当 AI 助手常驻浏览器侧边栏、不用再打开专门页面,使用门槛又低了一截。
AI 的入口,正在从「应用」变成「浏览器的一部分」。
Claude Cowork。
AutoGPT 展示如何用 AGENTS.md 和技能门控管理 AI 生成的拉取请求,让 AI 改代码前先过「该不该改」这一关。
当 AI 开始自己提 PR,工程管理需要新的「门」。
AGENTS.md 从文档变成了 AI 的「行为准则」。
AutoGPT 用 AGENTS.md。
社区讨论 DeepSeek-V4-Pro-0813 在长程任务中提前停止的问题,为了省 token 提前收工,还是任务真完成了?
当模型学会「省电」,它可能学会「偷懒」。
长程 Agent 的可靠性,正在成为比「聪明」更重要的指标。
Amazon 将默认用 Twitch 主播内容训练生成式 AI,除非用户主动退出,Ars Technica 报道了这一默认开启的「数据采集」。
主播的直播、剪辑、语音,被默认纳入训练集,退出要自己点。
当平台默认拿走你的内容喂 AI,「默认」两个字就是最大的坑。
Anthropic 与 Riot Platforms 签订 20 年、91 亿美元算力协议,锁定德州设施 191 兆瓦电力为 Claude 供能。
一边 60 亿收购补模型,一边 91 亿锁定算力,头部实验室的竞争,已经变成以十年为单位的资本锁定。
AI 的军备竞赛,从「谁更强」变成了「谁先锁死资源」。
Anthropic 锁定 20 年算力。
「除非你懂概率,否则你不会明白为什么大模型偶尔会答错。」
— Lord Tarassenko · 机器学习研究者 · Financial Times
「为了省 token 提前收工,还是任务真完成了。」
— 社区讨论 · DeepSeek-V4-Pro 长程任务 · SemiAnalysis
Anthropic 60 亿收购 Decart 补世界模型,91 亿锁定 20 年算力。
Grok 4.6 追平 GPT-5.6 Sol,长程 Agent 成新战场。
多数日本企业还没拥抱 AI;AutoGPT 用 AGENTS.md 管 AI 的代码。
头部在抢资源,边缘在观望,安全在被武器化,AI 的 2026,每个玩家都在找自己的位置。
阿拉斯加的火山群,冰川与岩浆共存。
Iliamna Volcano, Alaska, USA · NASA · 60.03°N, 153.09°W
看了一天 AI 的新闻,地球上还有不需要 GPU 冷却的地方。山川湖海,让我们保持好奇、继续探索。